AI Дайджест1 новость

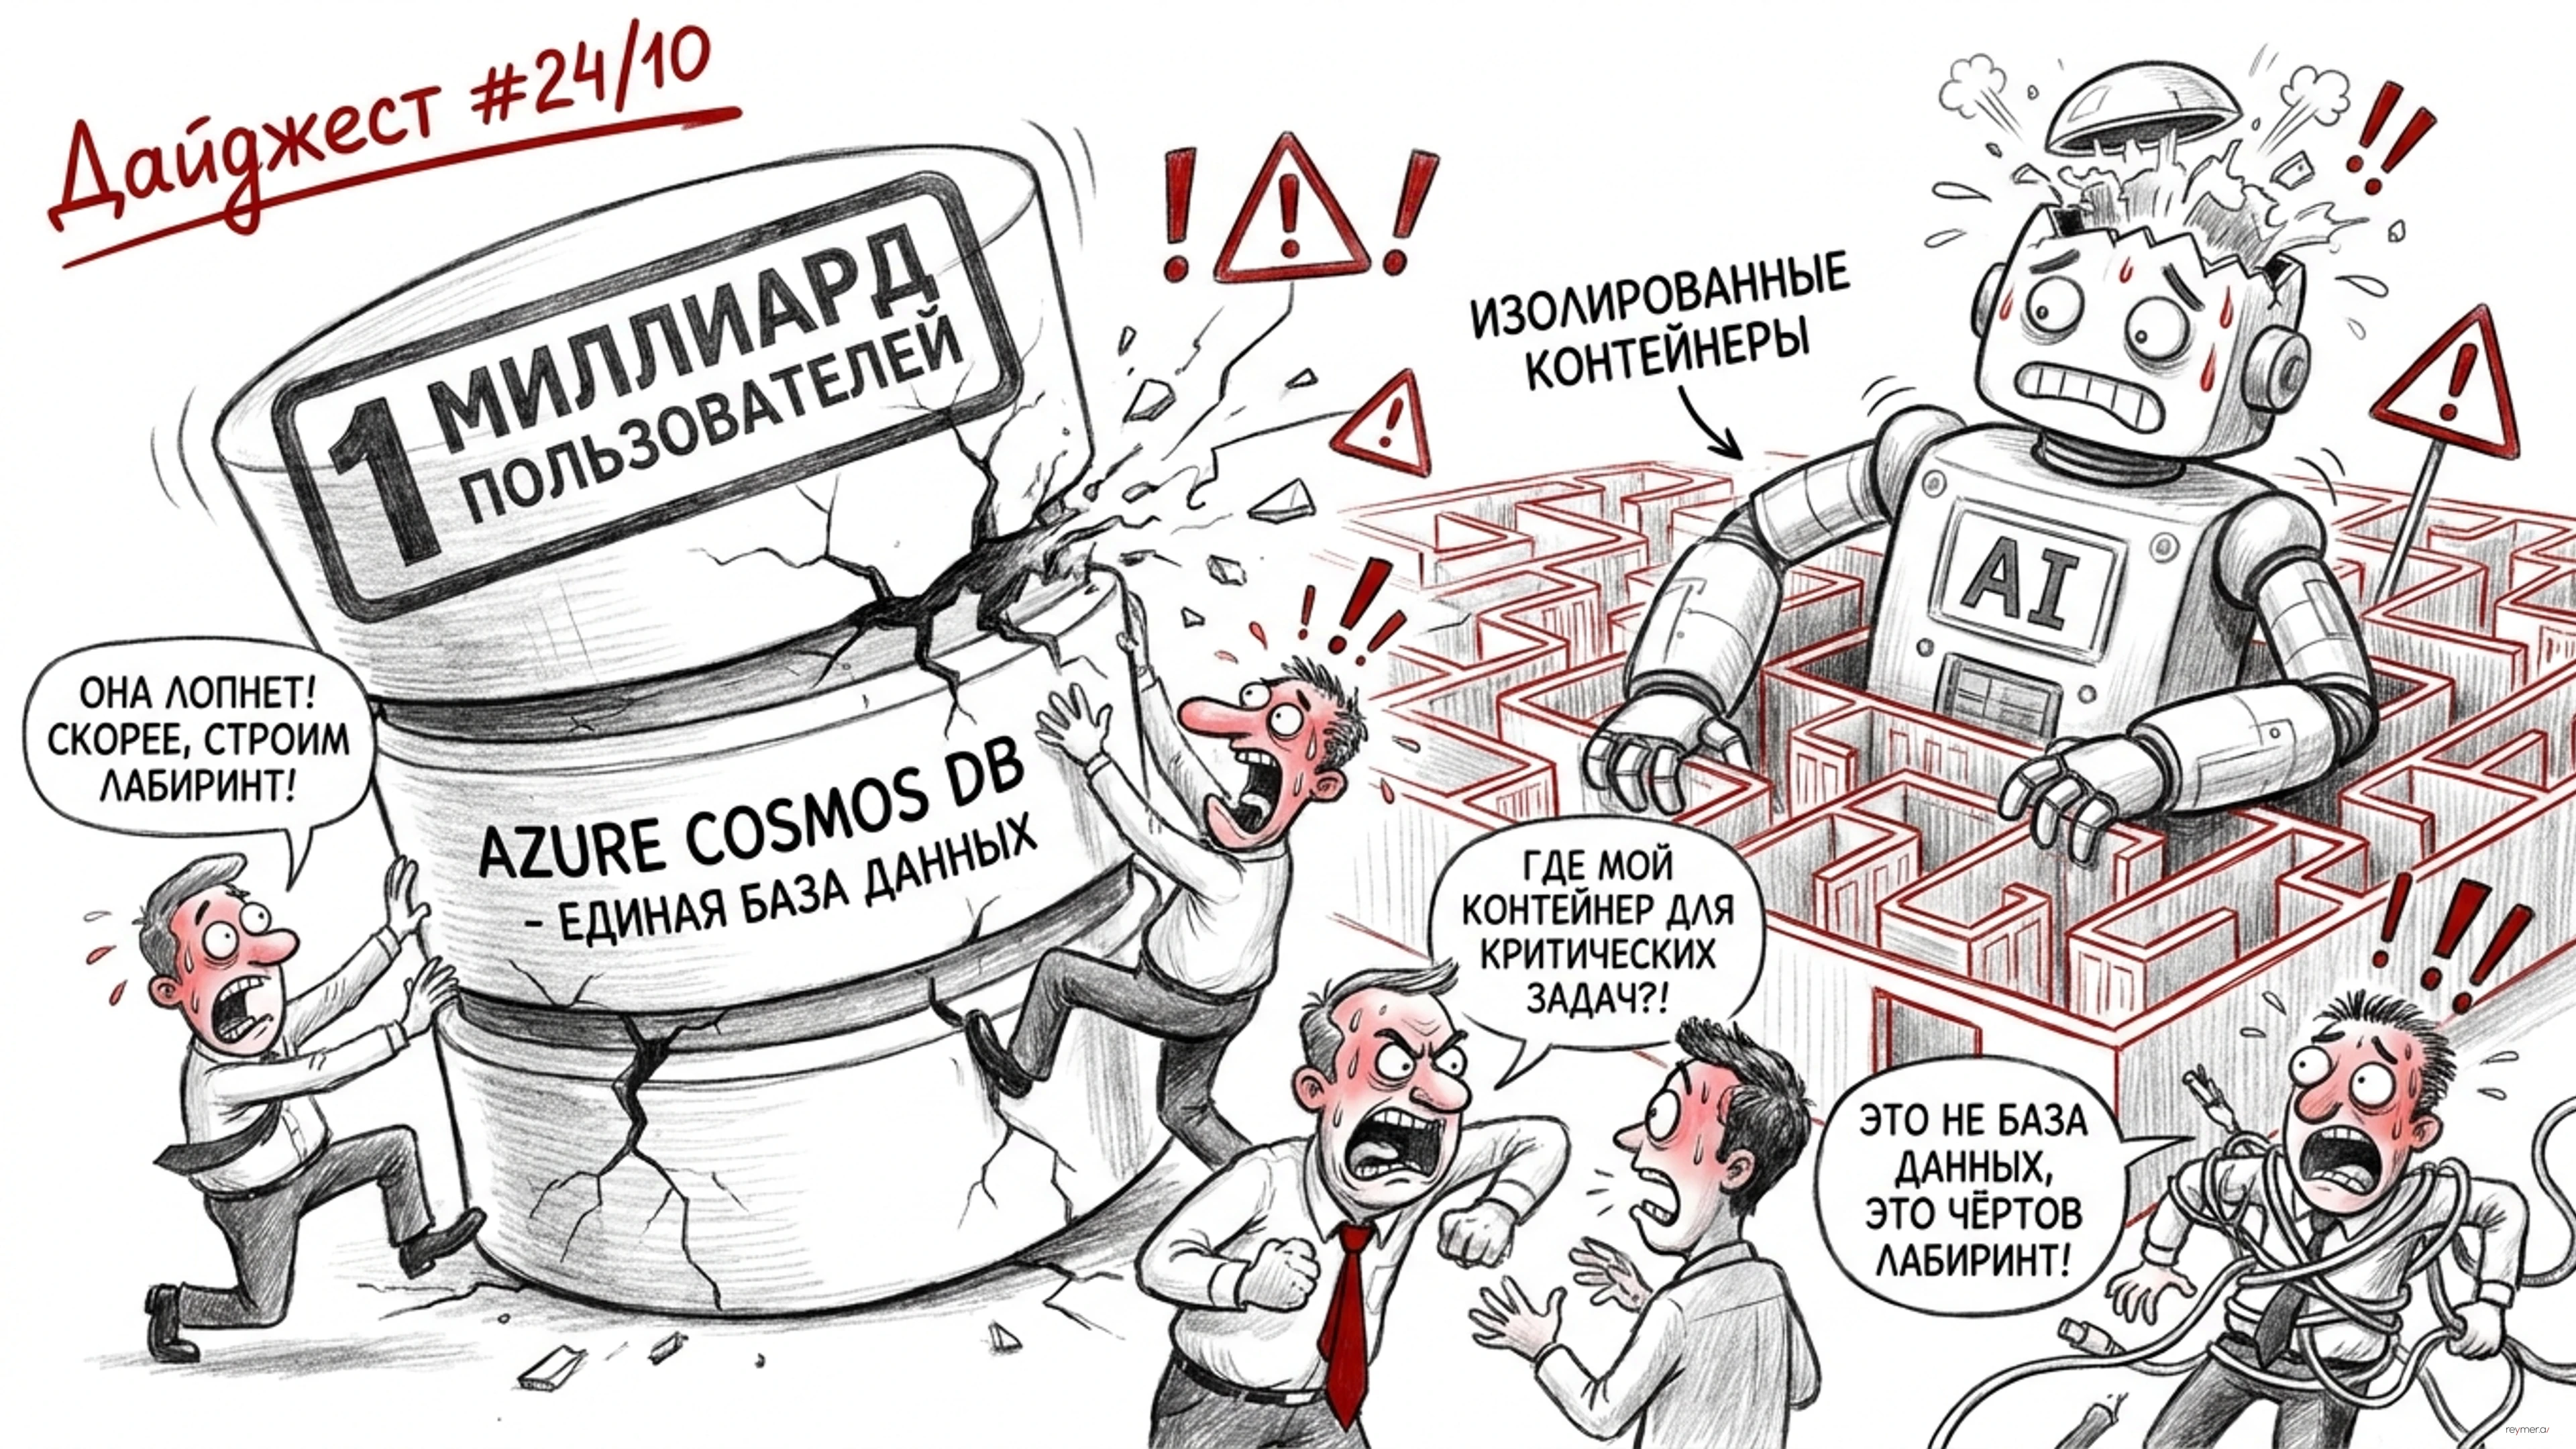
Как OpenAI справляется с миллиардом пользователей: уроки масштабирования

23 октября — 24 октябряОпубликовано: 24 октября 2026 г. в 20:48

Сегодняшний день показывает обратную сторону взрывного роста AI-продуктов. На примере OpenAI мы видим, что масштабирование до миллиарда пользователей требует фундаментальной перестройки архитектуры баз данных. Обычные облачные решения перестают работать из коробки, требуя сложной изоляции и обхода жестких аппаратных лимитов.

Как OpenAI справляется с миллиардом пользователей: уроки масштабирования

Цифры дня

NVIDIA

$210.96

-0.6%

Microsoft

$524.51

+0.7%

CrowdStrike Holdings, Inc.

$257.57

+8.3%

мувер дня

AI Bubble Index

46

-1.0

Осторожность

Главное событие

Перестройка архитектуры OpenAI

Для поддержки миллиарда пользователей OpenAI пришлось отказаться от единой базы данных в пользу сложной системы изолированных контейнеров. Это демонстрирует, что сверхпопулярные AI-сервисы неизбежно упираются в архитектурные лимиты облачных провайдеров.

Инсайты дня

Рост объема данных в облаке может парадоксальным образом снижать скорость работы из-за фрагментации серверов.

Руководителям стоит закладывать риски падения производительности баз данных при кратном росте клиентской базы, не надеясь на автоскейлинг.

Платформенные ограничения облачных провайдеров неизбежно становятся узким горлышком для AI-проектов.

При проектировании высоконагруженных систем необходимо заранее планировать нестандартные архитектурные решения и изоляцию компонентов.

Кратный рост скорости работы достигается архитектурной изоляцией данных, а не наращиванием вычислительных мощностей.

Оптимизация логики хранения дает больший и более дешевый эффект для AI-продуктов, чем простое увеличение бюджета на инфраструктуру.

Радар

Масштабирование инфраструктуры для AI-продуктов - это не просто покупка дополнительных серверов, а полная перестройка фундамента. Как показывает опыт OpenAI, поддержка более миллиарда пользователей заставляет переосмыслить привычные подходы к хранению данных.

Их внутренняя платформа Habitat, развернутая в 40 регионах, сегодня управляет поистине астрономическим объемом данных - более 500 петабайт. Однако этот рост выявил критическую проблему облачных баз данных: при таких масштабах Azure Cosmos DB перестает справляться с нагрузкой в рамках стандартной архитектуры.

Главной болью инженеров стал жесткий лимит в 10 000 RU/s на логический ключ. Рост объема хранилища приводит к автоматическому дроблению физических серверов, что, как ни парадоксально, снижает пропускную способность для каждого отдельного сегмента. Решением стал переход от единой базы данных к сложной системе изолированных контейнеров.

Эта оптимизация не просто спасла систему от коллапса, но и позволила увеличить скорость чтения данных для ChatGPT в 12 раз. Урок для руководителей очевиден: облачные сервисы масштабируются лишь до определенного предела, после которого вам придется строить собственную логику поверх платформенных ограничений.