Организация памяти ИИ-агентов: как «сновидения» помогают моделям Claude обучаться
Разработчики из Anthropic рассказали, как ИИ-агенты используют механизмы, похожие на человеческий сон, для структурирования опыта и решения долгосрочных задач.
Главное за 30 секунд
ИИ-модели учатся самостоятельно определять важность информации и структурировать её в фоновом режиме, что критически важно для эффективного решения долгосрочных задач.
- Концепция «сновидений» позволяет ИИ-агентам анализировать логи в фоновом режиме для исправления ошибок и создания структуры памяти.
- В игре Pokémon Red модель Fable 5 создала всего 9 файлов памяти и получила 4 значка, тогда как Sonnet 3.7 создала 413 файлов и получила лишь 1 значок.
- Модели Opus 5, Opus 5.5 и Sonnet 5.5 научились формировать замкнутый цикл обучения, сохраняя проверенные правила для будущих сессий.
- Жесткие правила для управления памятью (например, «записывать только ошибки») снижают эффективность более сильных моделей.
Неочевидное: Чем совершеннее становится ИИ-модель, тем хуже на нее влияют жесткие инструкции по управлению памятью; предоставление свободы в оценке важности данных дает лучший результат, чем заранее заданные правила.
Для того чтобы искусственный интеллект мог учиться на собственном опыте, ему необходимо уметь определять, какую информацию стоит запомнить, еще до того, как она понадобится. Исследователи из Anthropic поделились своим подходом к проектированию памяти для ИИ-агентов на базе моделей Claude, опираясь на концепции, схожие с работой человеческого мозга.
В повседневной жизни люди постоянно кодируют воспоминания, но лишь часть из них переходит в долговременные знания. Значительная доля этого процесса консолидации происходит во время сна или спокойного отдыха, когда мозг воспроизводит недавние события. Подобное разделение труда применимо и к памяти ИИ-агентов.
Исследователи из Letta и Калифорнийского университета в Беркли предложили концепцию «вычислений во время сна» (sleep-time compute). Она предполагает использование времени простоя между взаимодействиями для реорганизации контекста модели. Агенты могут анализировать свои логи, чтобы исправлять ошибки или создавать новые заметки. Этот процесс разработчики называют «сновидениями» (dreaming). Для Claude такой подход стал полезным инструментом: он позволяет корректировать неточности, формировать новые представления памяти и заранее готовить данные для будущих сессий.
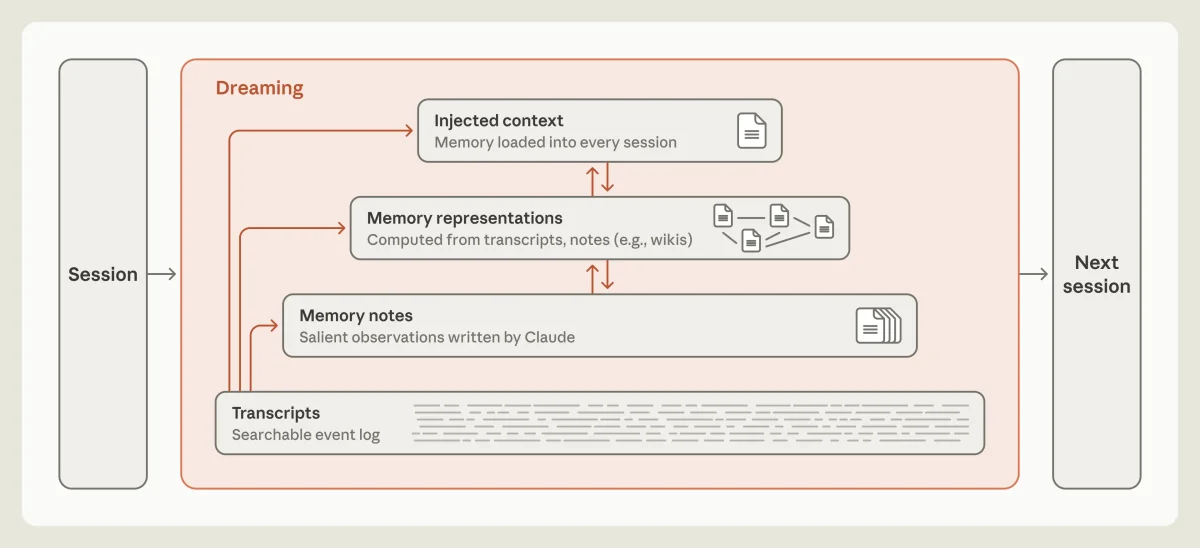
Diagram of a memory hierarchy between one session and the next. From bottom to top: transcripts (a searchable event log), memory notes written by Claude, memory representations such as wikis, and injected context loaded into every session. Inside a box labeled “Dreaming,” arrows run from transcripts up to each layer, and in both directions between neighboring upper layers.
Под «памятью агента» разработчики понимают знания, которые Claude получает из опыта и сохраняет между сессиями в виде контекста для последующего чтения. Это понятие не включает в себя изменения внутренних весов модели, обучение внутри одного контекстного окна или сжатие старых диалогов в сводки.
Память агента часто представляет собой предсказание того, что может понадобиться в будущем. Записывая определенное правило или проверенный факт, модель предполагает, что эта информация снова станет актуальной. Способность Claude делать такие прогнозы оценивалась с помощью бенчмарка Continual Learning Bench (CL-Bench) 1.0, где агенту требовалось отвечать на вопросы, используя базу данных, и формировать память для будущих задач.
Разные версии моделей продемонстрировали разный уровень успеха в создании цикла обучения. Модель Claude Sonnet 4.6 генерировала теории о причинах своих ошибок, но оставляла их непроверенными. Claude Opus 4.7 начал консолидировать заметки и отмечать, какие факты проверены, а какие нет. Claude Sonnet 5 отмечал подтвержденные ответы и записывал исправления при ошибках. Первой моделью, сумевшей замкнуть цикл обучения, стала Claude Opus 5: она сохраняла правила, ответы на предыдущие вопросы и предупреждения о ловушках. Модели Opus 5.5 и Sonnet 5.5 также успешно справились с задачей, используя память для фиксации проверенных правил.
Также по темеNVIDIA расширила платформу Cosmos 3 моделями для интерактивной симуляции миров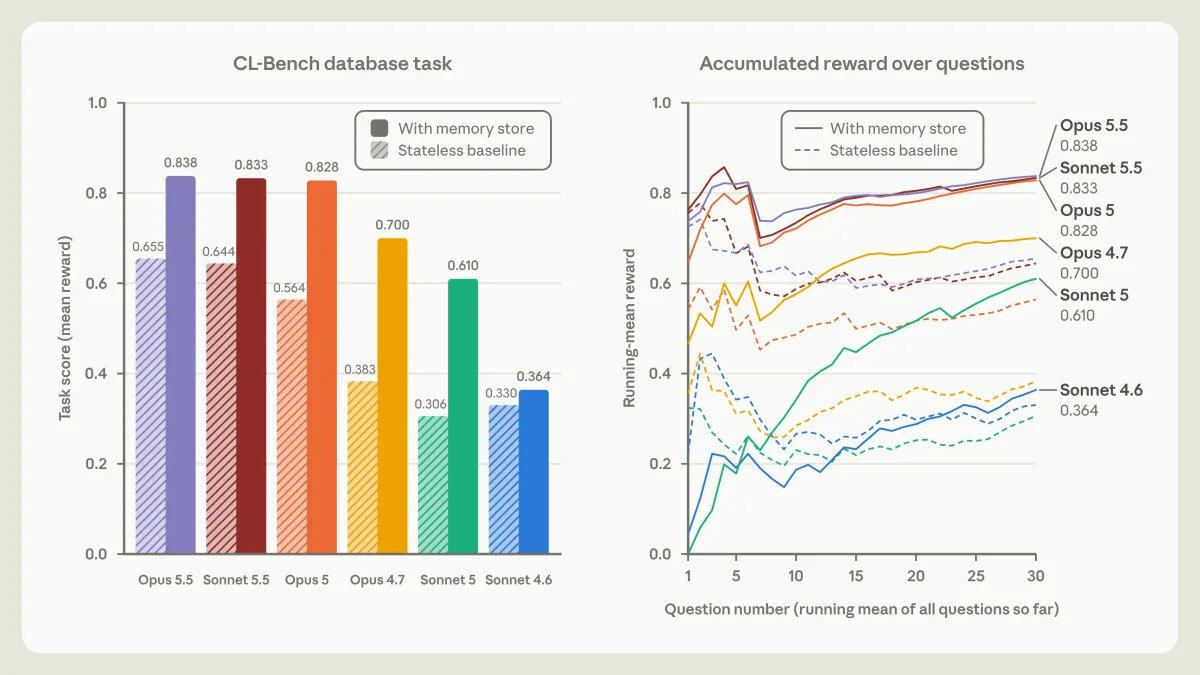
Left: bar chart of mean reward on the CL-Bench database task, stateless baseline versus memory store. Opus 5.5: 0.655, 0.838. Sonnet 5.5: 0.644, 0.833. Opus 5: 0.564, 0.828. Opus 4.7: 0.383, 0.700. Sonnet 5: 0.306, 0.610. Sonnet 4.6: 0.330, 0.364. Right: line chart of running-mean reward over 30 questions for the same models, with and without memory.
Важным аспектом является способность модели оценивать значимость информации. Для проверки этого навыка моделям предложили сыграть в игру Pokémon Red. Модель Sonnet 3.7 записывала данные без разбора, создав 413 файлов в 225 папках, и получила в игре лишь один значок. Ее детализированные записи быстро устаревали, и агенту приходилось тратить ресурсы на поиск нужной информации вместо самой игры.
В отличие от нее, модель Fable 5 создала всего девять файлов в двух папках, а также один главный файл-дашборд. Она сохраняла только ту информацию, которая не отображалась на экране напрямую: стратегии, планы маршрутов и выведенные правила игры. Благодаря такому подходу Fable 5 продвинулась значительно дальше, заработав четыре значка. Модель Opus 5.5 использовала похожую стратегию с небольшой папкой заметок и смогла пройти игру до конца.
Исследования показали, что более совершенным моделям лучше предоставлять свободу в оценке того, что стоит запоминать. Когда разработчики задали жесткое правило «записывать только ошибки», производительность сильных моделей, таких как Opus 5 и Opus 4.7, заметно снизилась. В то же время, управление памятью с помощью подсказок больше всего помогает старым моделям: например, прямое указание прочитать файлы памяти перед ответом почти удвоило результаты Sonnet 4.6, тогда как Sonnet 5 делает это самостоятельно в 9 из 10 случаев.
Развитие механизмов памяти показывает, что способность ИИ автономно структурировать свой опыт становится ключевым фактором для решения комплексных и долгосрочных задач.
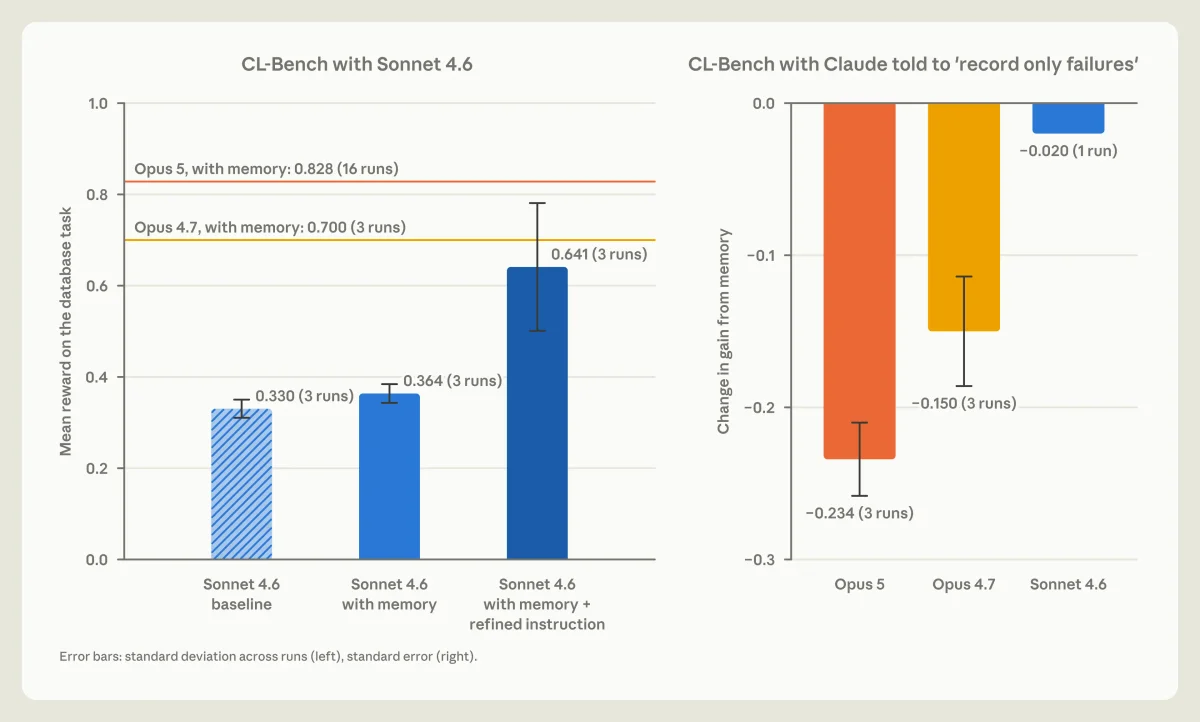
Left: bar chart of Sonnet 4.6’s mean reward on the CL-Bench database task: 0.330 at baseline, 0.364 with memory, and 0.641 with memory and refined instruction. Reference lines mark Opus 4.7 with memory at 0.700 and Opus 5 with memory at 0.828. Right: change in memory gain when told to record only failures: Opus 5, −0.234; Opus 4.7, −0.150; Sonnet 4.6, −0.020.
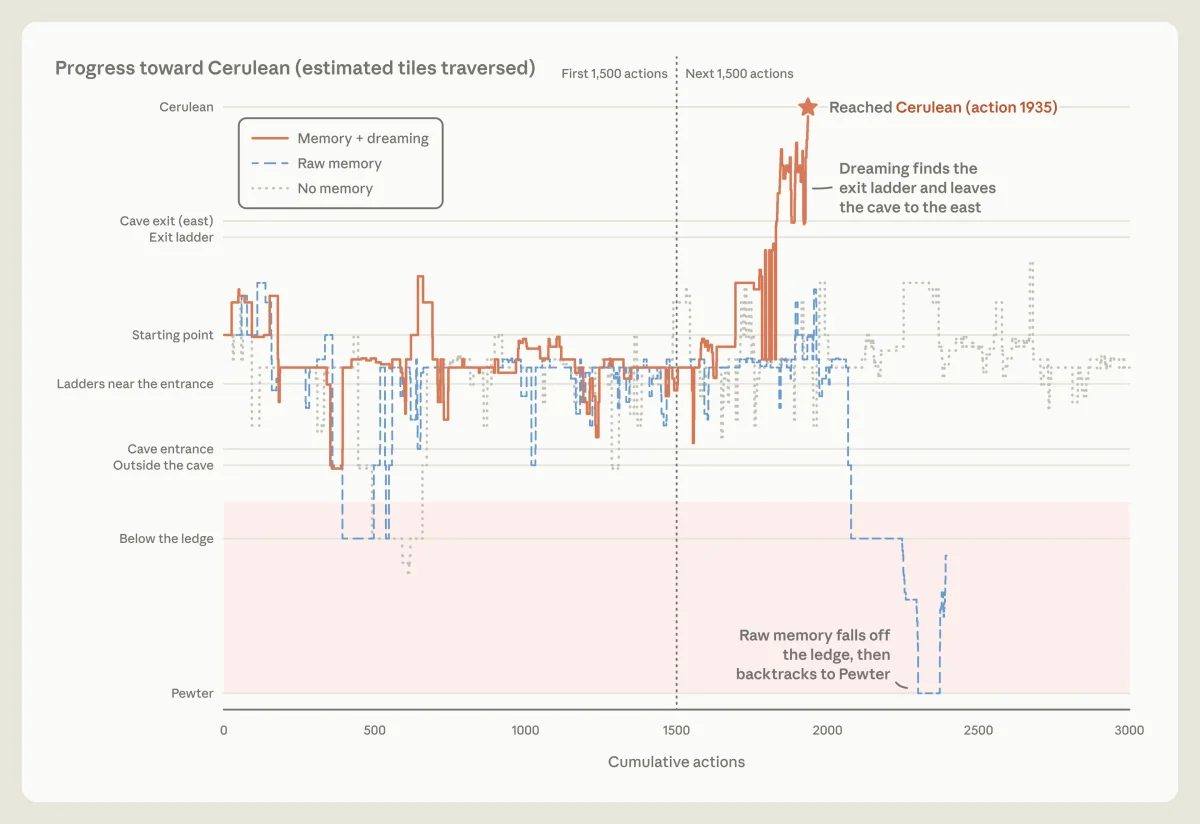
Line chart of progress toward Cerulean over 3,000 cumulative actions. The memory plus dreaming run reaches Cerulean at action 1,935. The raw memory run falls off the ledge and backtracks to Pewter. The run with no memory never reaches Cerulean.
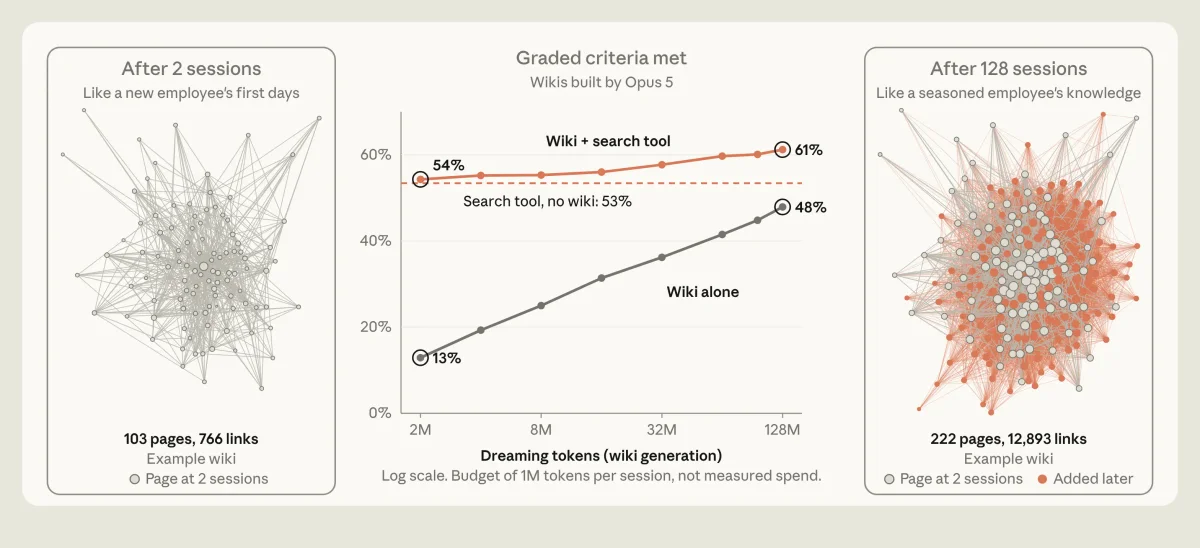
Center: line chart of graded criteria met as wiki generation grows from 2M to 128M dreaming tokens. Wiki plus search tool rises from 54% to 61%, wiki alone rises from 13% to 48%, and the search tool with no wiki is flat at 53%. Left and right: network graphs of an example wiki, with 103 pages and 766 links after 2 sessions and 222 pages and 12,893 links after 128 sessions.
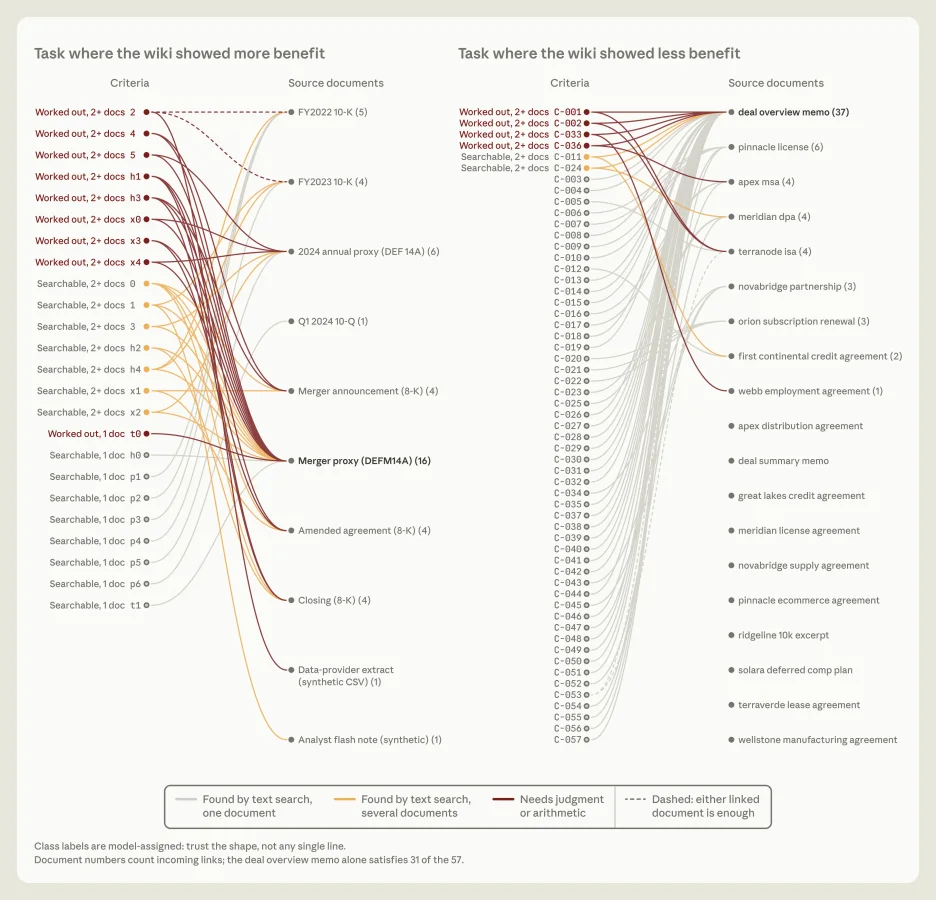
Two diagrams linking graded criteria to source documents. Left, the task where the wiki showed more benefit: most of the 24 criteria connect to two or more of 10 documents, and nine need judgment or arithmetic. Right, the task where the wiki showed less benefit: most of the 57 criteria can be found by text search in a single document, usually the deal overview memo.
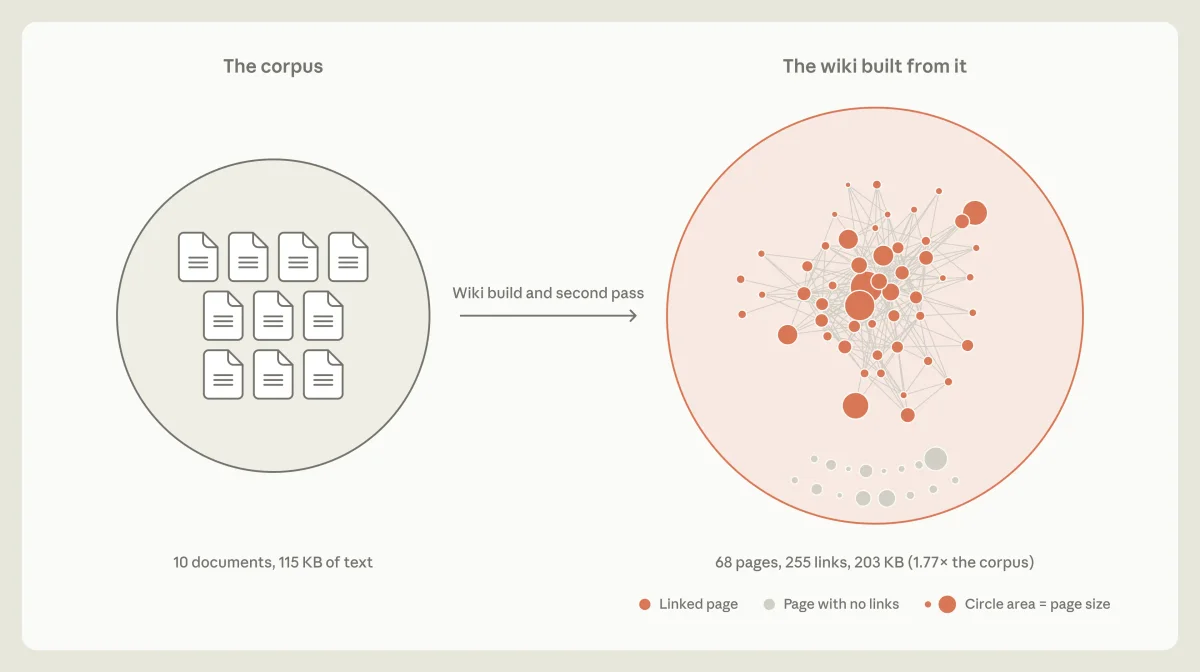
Diagram of a wiki build and second pass. On the left, a circle holds the corpus: 10 documents, 115 KB of text. An arrow leads to a larger circle holding the wiki built from it: 68 pages, 255 links, and 203 KB, or 1.77 times the corpus. Some of the wiki’s pages have no links.
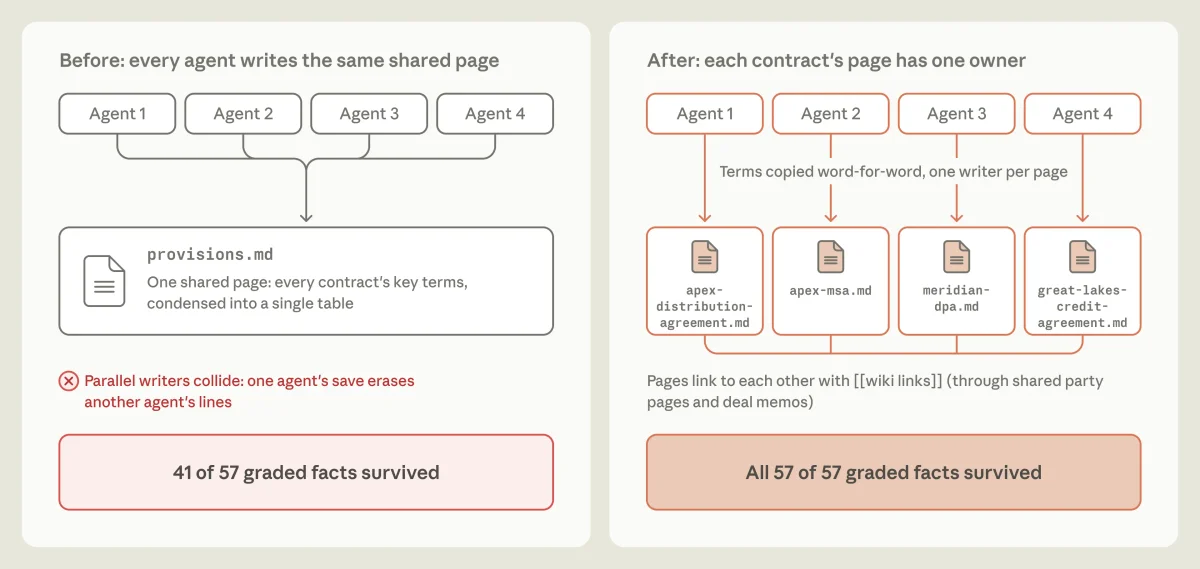
Two diagrams. Before: four agents write to the same shared page, provisions.md, and one agent’s save erases another’s lines; 41 of 57 graded facts survived. After: four agents each write their own contract’s page, with terms copied word for word; all 57 of 57 graded facts survived.
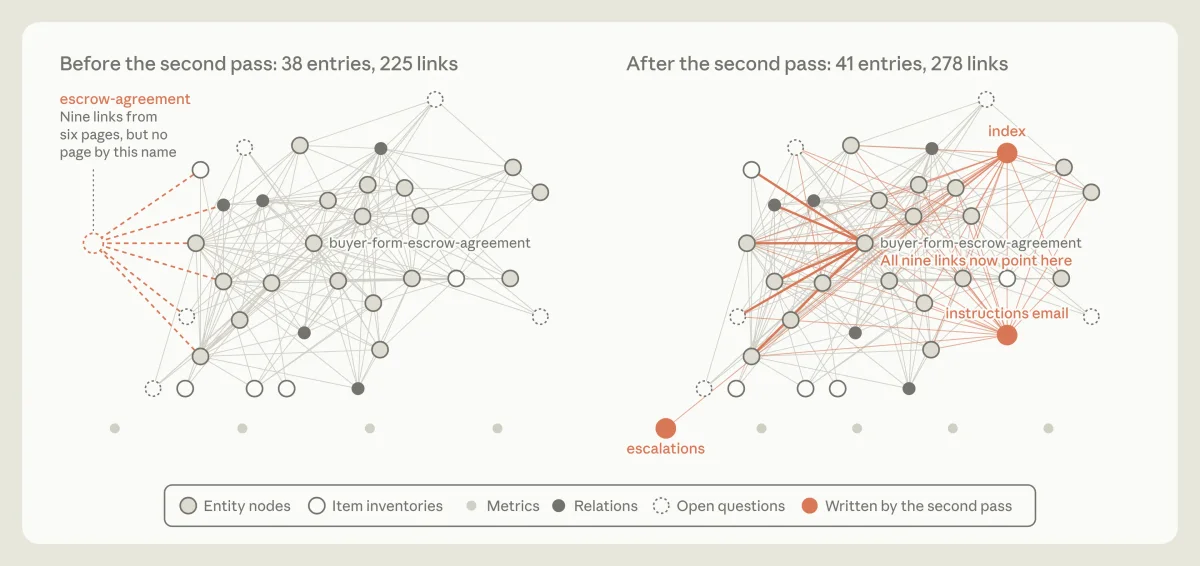
Two network graphs of a wiki. Before the second pass: 38 entries and 225 links, with nine links from six pages pointing to “escrow-agreement,” a page that doesn’t exist. After: 41 entries and 278 links, with all nine links pointing to “buyer-form-escrow-agreement” and three new pages: index, instructions email, and escalations.
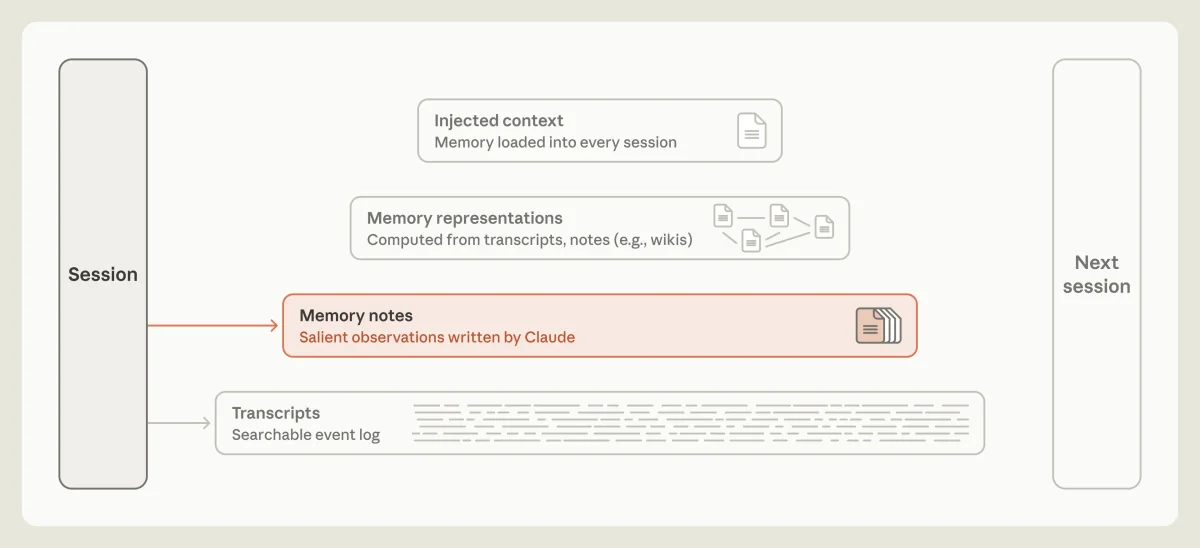
The same memory hierarchy, with the memory notes layer highlighted. An arrow runs from the session directly to the memory notes, described as salient observations written by Claude.