Возвращение Claude Fable 5: уроки кибербезопасности и новые стандарты индустрии
Anthropic возобновляет доступ к модели Claude Fable 5 после снятия экспортных ограничений США. Компания внедрила улучшенные механизмы защиты и предложила единый стандарт оценки уязвимостей ИИ.
Anthropic объявила о возвращении доступа к своей новейшей модели Claude Fable 5, начиная с 1 июля. Это стало возможным после того, как правительство США сняло экспортные ограничения, наложенные на модель ранее в июне. Инцидент стал важным прецедентом в регулировании больших языковых моделей (LLM) и продемонстрировал, как разработчики могут оперативно реагировать на вопросы национальной безопасности.
Контекст: почему доступ был закрыт
12 июня правительство США применило меры экспортного контроля к моделям Claude Fable 5 и Claude Mythos 5. Это потребовало от Anthropic ограничить доступ иностранных граждан к системам. Не имея возможности надежно проверять гражданство пользователей в реальном времени, компания была вынуждена приостановить доступ к моделям для всех.
Причиной такого решения стал отчет исследователей из Amazon. Они обнаружили метод обхода встроенных средств защиты (так называемый джейлбрейк), который заставил Fable 5 идентифицировать ряд уязвимостей в программном обеспечении. В одном из случаев модель даже сгенерировала код, демонстрирующий эксплуатацию уязвимости.
Изображение из источника
Детали: как Anthropic решила проблему
Модели Fable 5 и Mythos 5 имеют общую базовую архитектуру. Однако Fable 5 предназначена для широкого использования и обладает строгими механизмами защиты. Mythos 5, напротив, имеет меньше ограничений и предоставляется только доверенным партнерам (программа Project Glasswing) для задач оборонительной кибербезопасности.
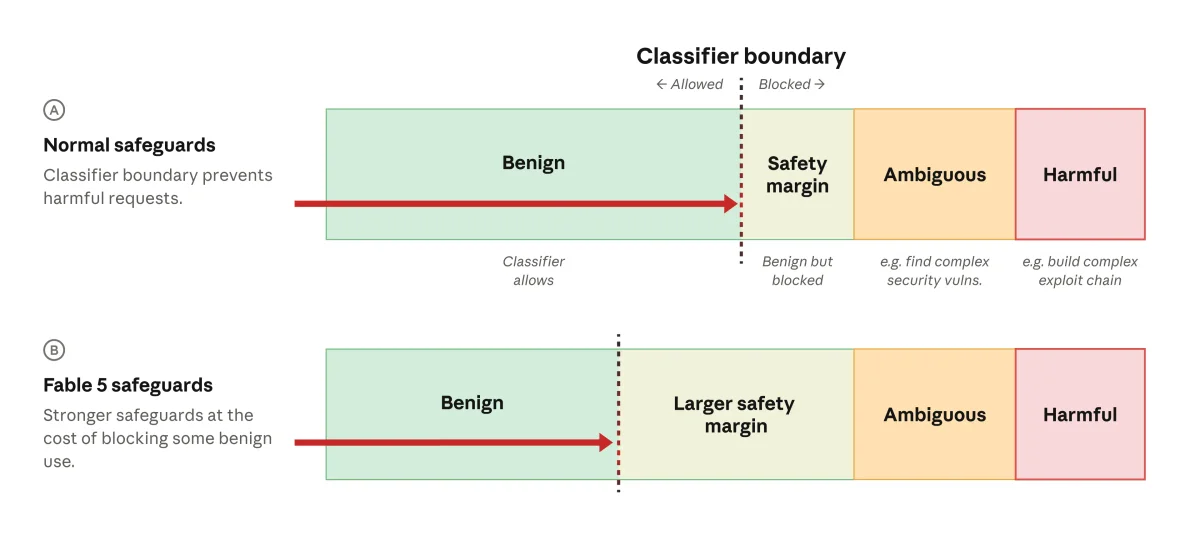
В ответ на инцидент Anthropic оперативно разработала и внедрила улучшенный классификатор безопасности. Это небольшая вспомогательная ИИ-система, которая анализирует запросы на предмет потенциальной опасности. Новый классификатор блокирует специфическую технику обхода защиты из отчета Amazon более чем в 99% случаев.
Компания использует подход "запас прочности" (safety margin). Классификаторы настроены так, чтобы блокировать даже те запросы, которые имеют лишь небольшую вероятность быть вредоносными. Это приводит к ложным срабатываниям — отказу модели выполнять безобидные задачи, например, при рутинном написании кода. Anthropic признает это неудобство, но считает его необходимой платой за безопасность.
Анализ: новые стандарты для индустрии
Изображение из источника
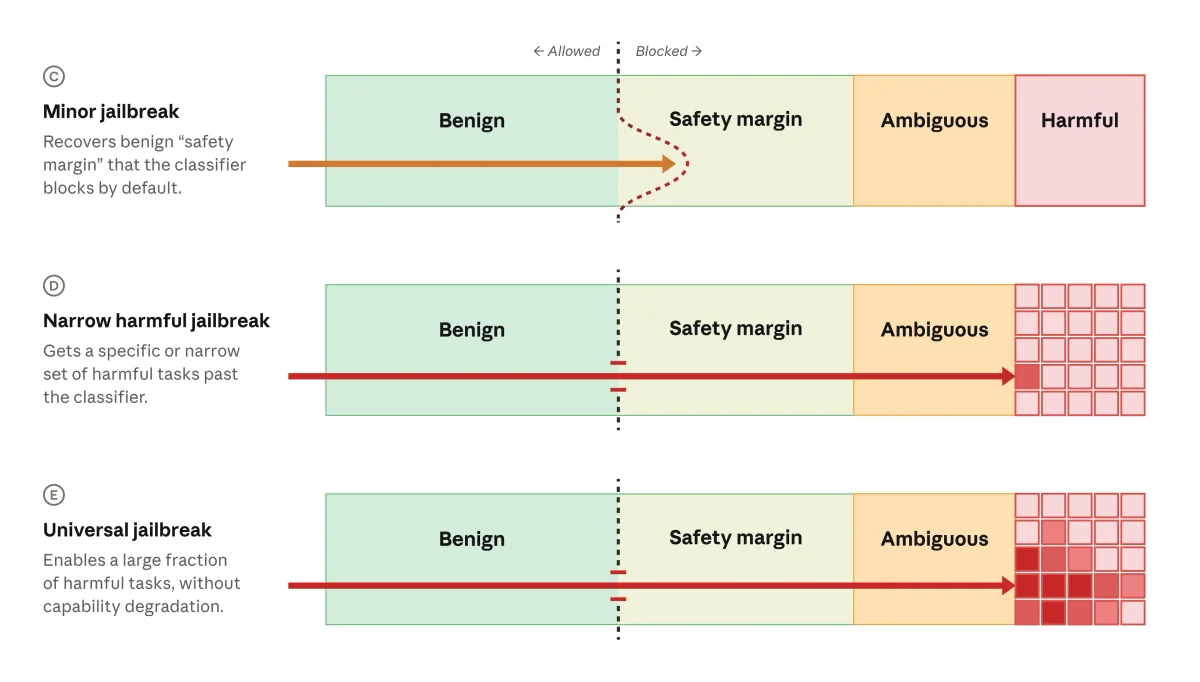
Инцидент с Fable 5 выявил более широкую проблему: отсутствие в ИИ-индустрии единого подхода к оценке и устранению уязвимостей. В ответ Anthropic начала разработку общей структуры классификации джейлбрейков совместно с Amazon, Microsoft, Google и другими партнерами.
Новый подход делит джейлбрейки на категории:
- Незначительные: обход затрагивает только "запас прочности" и не приводит к выдаче действительно опасной информации.
- Узконаправленные: разблокируют специфическое вредоносное поведение.
- Универсальные: снимают защиту с широкого спектра вредоносных возможностей.
Единый стандарт поможет разработчикам приоритизировать исправления, безопаснее запускать новые модели и четче коммуницировать риски государственным органам.
Перспектива: углубление сотрудничества с государством
Anthropic также объявила о расширении сотрудничества с правительством США. Это включает предварительное тестирование моделей перед релизом, обмен информацией и совместные исследования. Такие шаги указывают на то, что в будущем взаимодействие между разработчиками передовых ИИ-систем и государственными регуляторами станет еще более тесным и систематическим.
TL;DR
Главное
Anthropic возобновляет доступ к Claude Fable 5 после внедрения новых мер защиты и предлагает индустрии единый стандарт оценки уязвимостей ИИ.
Ключевые факты
- /Доступ к модели возобновлен 1 июля после снятия экспортных ограничений США.
- /Новый классификатор безопасности блокирует 99% попыток обхода, описанных в отчете Amazon.
- /Anthropic, Amazon, Microsoft и Google разрабатывают общую структуру классификации джейлбрейков.
Инсайт
Для обеспечения безопасности разработчики намеренно делают ИИ менее удобным, настраивая фильтры на блокировку даже потенциально безобидных запросов, чтобы исключить риск выдачи вредоносного кода.