Синтетические данные для корпоративных агентов: обзор проекта AutoSynthData от ServiceNow
Исследовательское подразделение ServiceNow-AI представило подход к автоматической генерации обучающих данных для корпоративных ИИ-агентов с использованием мультимодальных моделей.
Суть
Исследовательское подразделение ServiceNow-AI опубликовало материалы проекта AutoSynthData на платформе Hugging Face. Главная цель инициативы — автоматизация создания обучающих данных для корпоративных ИИ-агентов. Это важный шаг для индустрии, поскольку нехватка качественных специфических данных остается главным препятствием для массового внедрения автономного искусственного интеллекта в сложные бизнес-процессы.
Контекст
Обучение автономных агентов для работы с корпоративными системами требует огромного количества примеров действий, логов и сценариев. Исторически такие наборы данных собирались вручную разметчиками. Это долгий и дорогой процесс, который к тому же часто упирается в строгие корпоративные политики конфиденциальности. Использование больших языковых моделей (LLM) для генерации синтетических данных предлагает элегантное решение этой проблемы, позволяя масштабировать процесс создания датасетов без прямого участия человека и риска утечки реальных пользовательских данных.
Детали
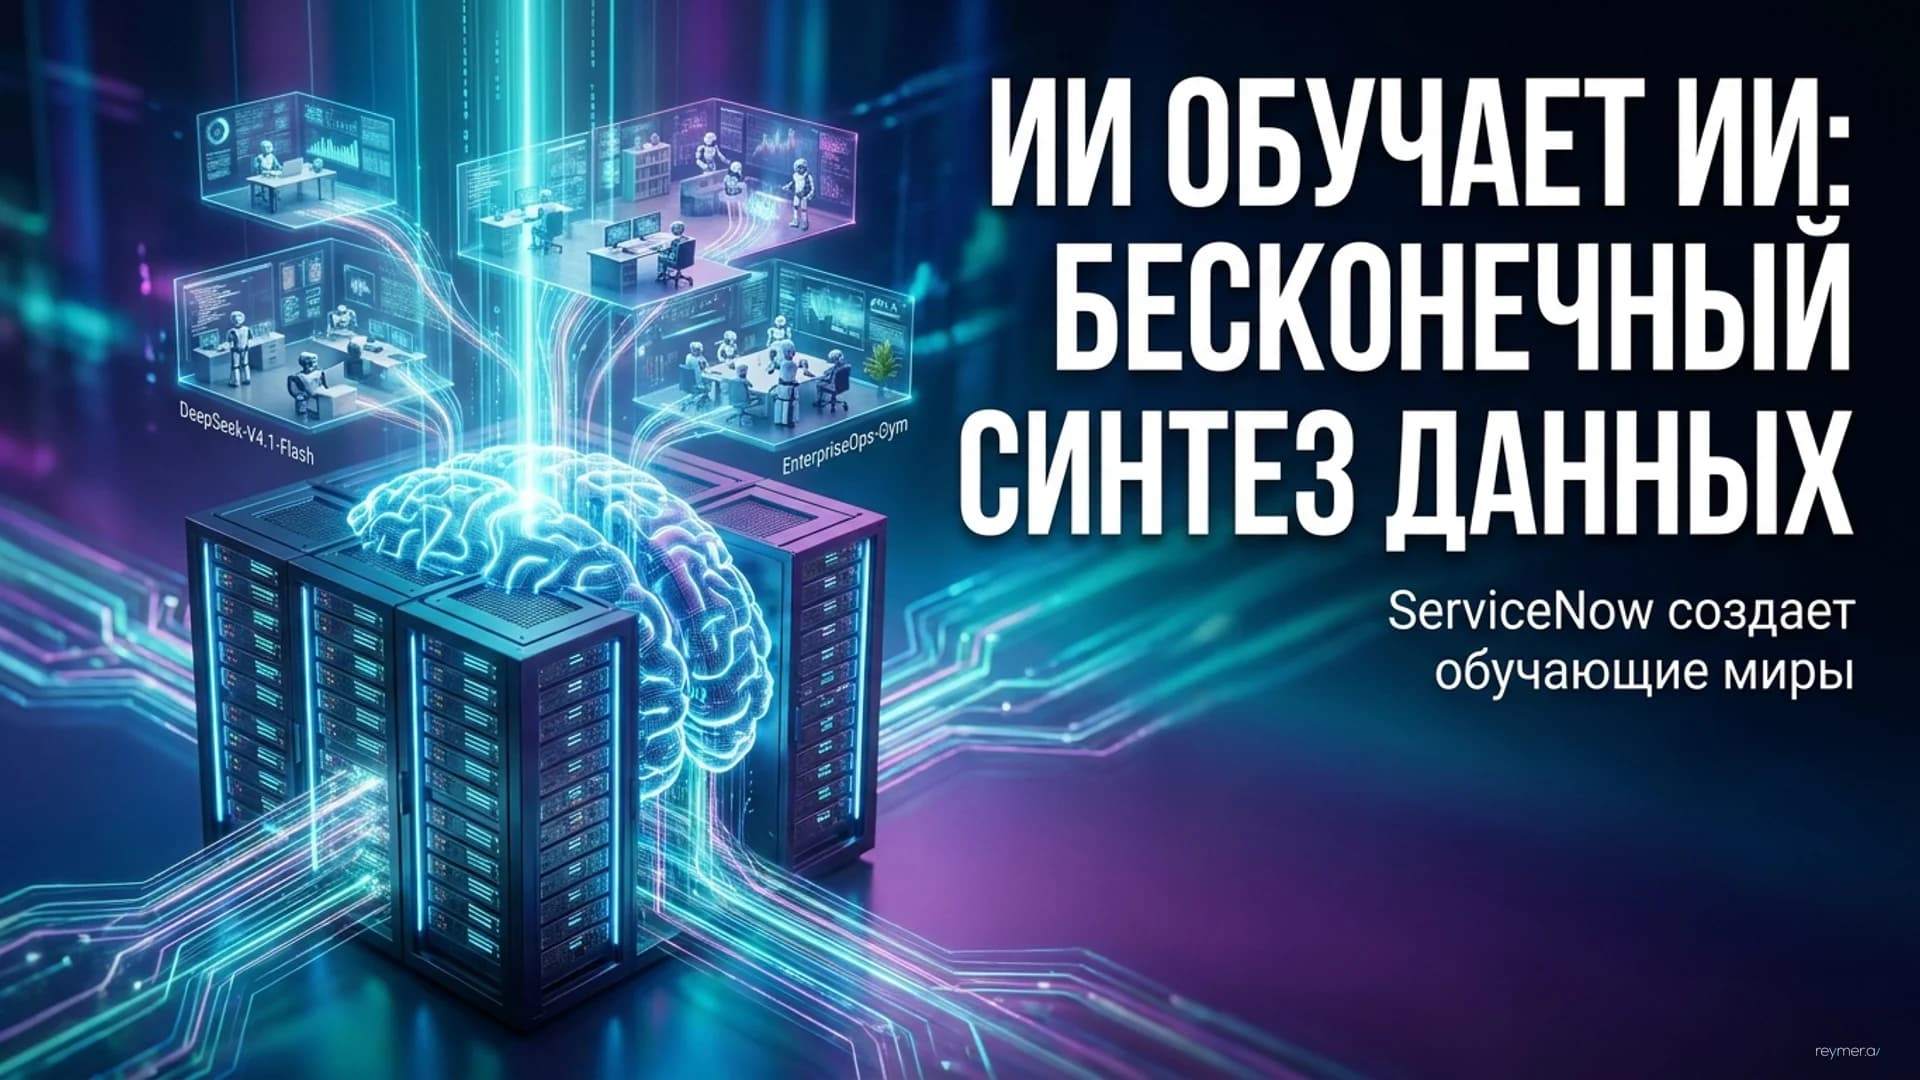
Судя по опубликованным репозиториям, в рамках проекта активно применяются передовые мультимодальные модели, способные обрабатывать как текст, так и изображения (Image-Text-to-Text). Для генерации данных используются решения разного масштаба. Среди них выделяются гигантская модель DeepSeek-V4.1-Flash с 763 миллиардами параметров, а также более компактные, но высокоэффективные Qwen3.8-27B от Alibaba и gemma-4-26B-A4B-it от Google. Эти модели способны анализировать скриншоты интерфейсов и текстовые инструкции, создавая тренировочные сценарии для специализированных сред, таких как симулятор EnterpriseOps-Gym.
Анализ
Применение мультимодальных моделей такого масштаба для генерации данных указывает на фундаментальное изменение парадигмы в разработке ИИ. Компании больше не пытаются собрать идеальный датасет исключительно из реального мира. Вместо этого они используют мощные базовые модели в качестве «учителей», которые синтезируют бесконечные вариации корпоративных задач. Это позволяет обучать более узкие, быстрые и дешевые модели-агенты, которые будут непосредственно выполнять рутинные операции в компаниях.
Перспектива
В ближайшем будущем способность компаний генерировать качественные синтетические данные станет их главным конкурентным преимуществом на рынке корпоративного ИИ. Проекты, подобные AutoSynthData, доказывают, что индустрия уверенно движется к автоматизации самого цикла создания искусственного интеллекта. Время покажет, насколько синтетические среды смогут заменить реальный опыт, но уже сейчас ясно, что машины, обучающие другие машины, становятся стандартом для enterprise-сегмента.
TL;DR
Главное
ServiceNow автоматизирует создание обучающих данных для корпоративных ИИ-агентов с помощью тяжелых мультимодальных моделей, решая проблему нехватки качественных датасетов.
Ключевые факты
- /Проект AutoSynthData использует модели формата Image-Text-to-Text.
- /В процессе задействована модель DeepSeek-V4.1-Flash на 763 млрд параметров.
- /Для обучения агентов применяется специализированная среда EnterpriseOps-Gym.
Инсайт
Вместо сбора реальных данных бизнеса, корпорации переходят к использованию гигантских моделей в роли генераторов бесконечных синтетических сценариев для обучения более мелких агентов.