Будущее вывода данных: почему фоновые AI-агенты требуют новой инфраструктуры
Рынок AI переходит от чатов реального времени к фоновым агентам. Стартап Sail Research привлек инвестиции на создание асинхронной инфраструктуры, радикально снижающей затраты на вычисления.
Рынок вывода данных (inference) — крупнейший сегмент в индустрии программного обеспечения. Сейчас мы наблюдаем фундаментальный сдвиг: рабочие нагрузки искусственного интеллекта переходят от синхронных чатов к асинхронным агентам, которые могут работать часами. На фоне этого стартап Sail Research объявил о привлечении инвестиций серии А от ведущих фондов, включая Sequoia, Kleiner Perkins и Redpoint. Их главная цель — оптимизировать пропускную способность вычислений на каждый потраченный доллар.
Сегодня почти весь вывод данных происходит в реальном времени. Человек печатает запрос, модель отвечает, и цикл повторяется. Вся инфраструктура построена с расчетом на пользователя, ожидающего ответа по ту сторону экрана. В такой парадигме каждая миллисекунда задержки стоит денег, потому что системы обслуживают запросы с упором на мгновенный запуск (cold-start), а не на общую пропускную способность. Для фоновых задач такой подход крайне неэффективен.
Когда разработчики начинают параллельно запускать десятки агентов для выполнения одной задачи в фоновом режиме, продуктивность резко возрастает. Однако стоимость таких вычислений на традиционной инфраструктуре становится неподъемной. Рынок вывода данных начинает четко делиться на три сегмента: реальное время, около-реальное время и пакетная обработка (batch). Асинхронный вывод относится к последнему и обладает огромным экономическим преимуществом.
sail
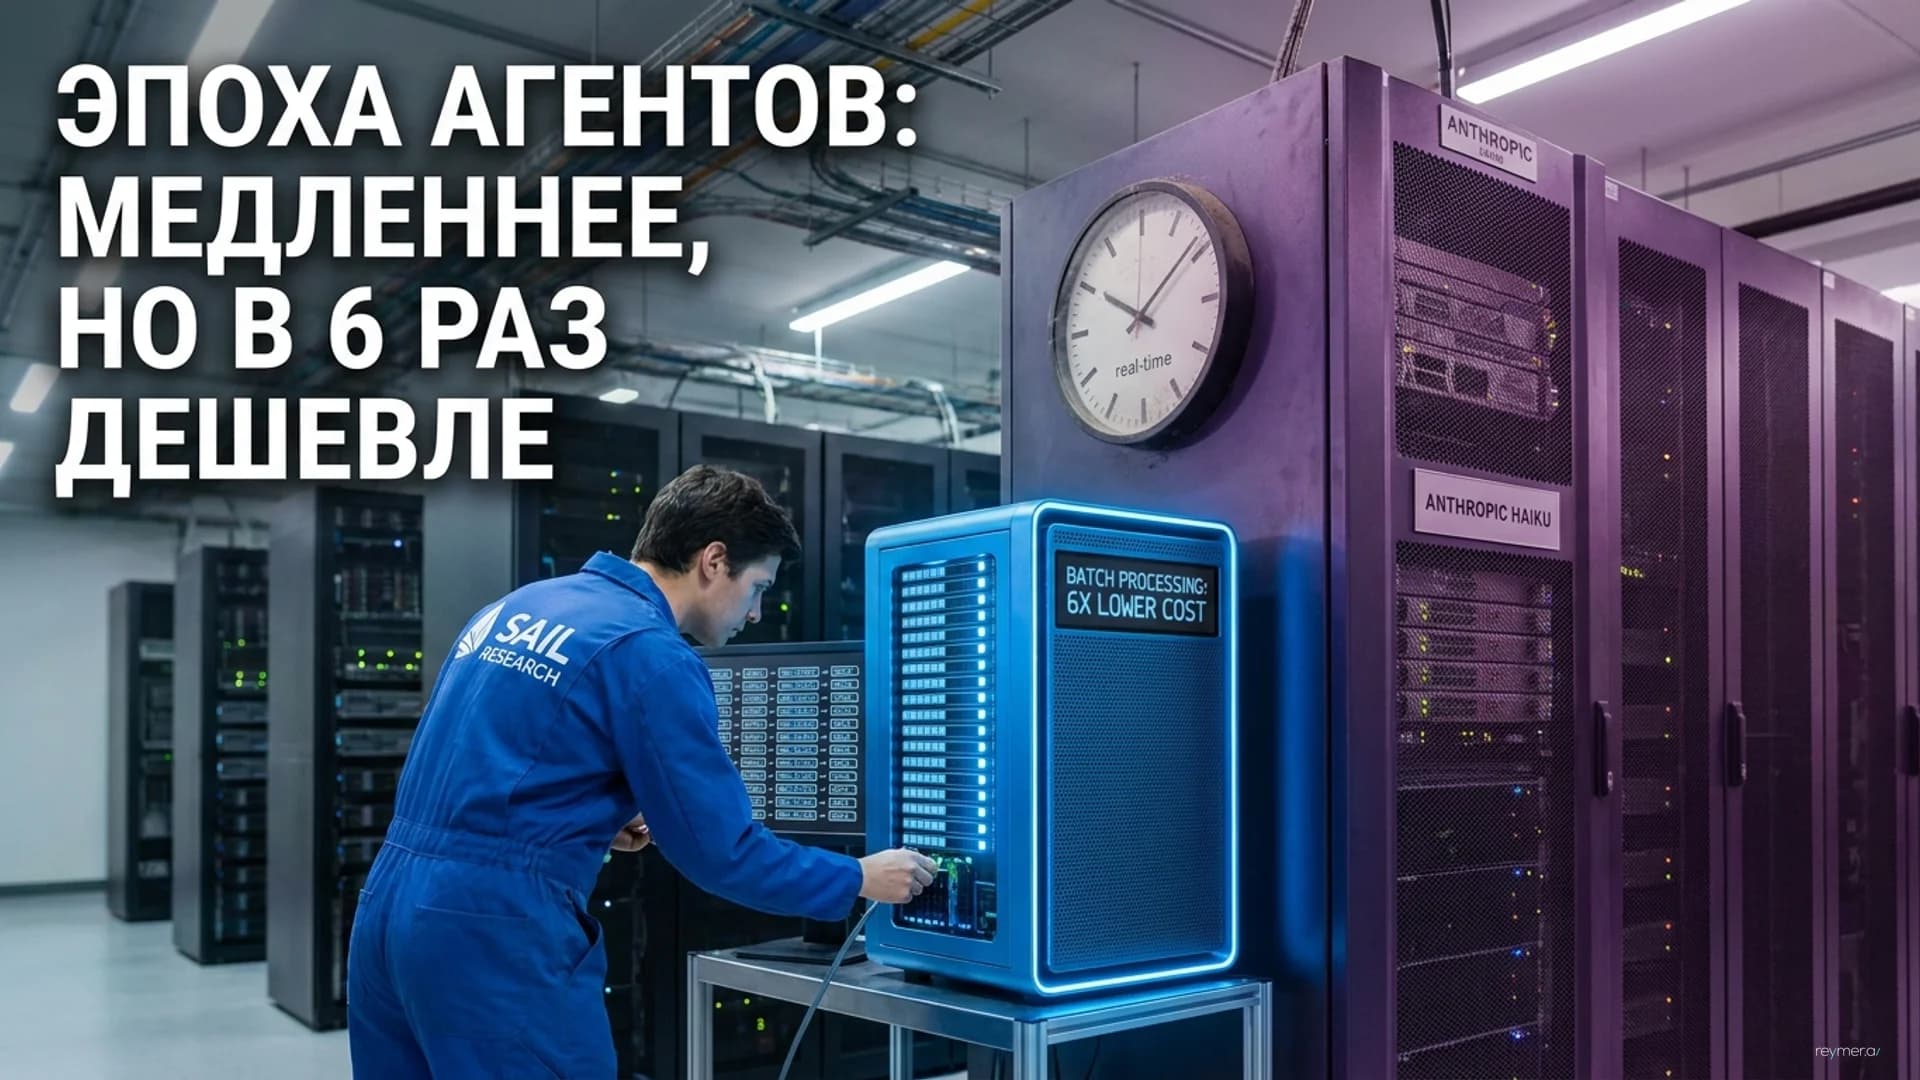
Ключ к снижению затрат кроется в умной маршрутизации и выборе моделей. Платформа Sail распределяет запросы между открытыми моделями, такими как DeepSeek, Qwen, Kimi и GLM, выбирая наиболее дешевую, но способную справиться с задачей модель. Цифры показательны: использование модели GLM-5.1 через Sail обходится в шесть раз дешевле за токен, чем использование Anthropic Haiku. Если разработчик готов подождать две минуты вместо двух секунд для автоматического ревью кода, он экономит колоссальные средства.
Технически это реализовано через использование резервных мощностей (spot capacity) с автоматическим переключением на выделенные серверы при их нехватке. Система упаковывает запросы в простаивающие мощности, максимизируя утилизацию оборудования. Традиционные системы реального времени вынуждены резервировать вычислительные ресурсы под каждый отдельный запрос, чтобы гарантировать минимальную задержку. Разная архитектура порождает совершенно разную экономику.
Основатели проекта, Нил Мовва (Neil Movva), создававший инфраструктуру в Together AI, и Самир Менон (Samir Menon), работавший в Blyss, разработали концепцию «Sailboxes». Это специализированные облачные среды, созданные для неравномерного ритма работы автономных агентов. Такая среда сохраняет контекст на протяжении выполнения всей задачи, автоматически ставится на паузу во время ожидания ответа от языковой модели и возобновляет работу за секунды, когда ответ получен. Главное преимущество для бизнеса — оплата исключительно за время активной работы. Затраты на простой полностью исключаются.
По мере того как AI-агенты эволюционируют из простых чат-помощников в фоновых работников, которые по ночам сканируют базы кода, обогащают данные в CRM-системах и обрабатывают документы, подавляющее большинство токенов будет проходить через очереди. Будущее искусственного интеллекта работает в фоновом режиме, и специализированная инфраструктура для этого уже формируется.
TL;DR
Главное
Переход индустрии от чат-ботов к автономным фоновым агентам требует новой инфраструктуры на базе очередей, что позволяет радикально снизить стоимость вычислений.
Ключевые факты
- /Рынок вывода данных делится на реальное время и пакетную обработку.
- /Асинхронный подход Sail Research снижает стоимость токена до 6 раз по сравнению с Anthropic Haiku.
- /Клиенты платят только за активное время работы агента, полностью исключая оплату за простой серверов.
Инсайт
Задержка ответа (latency) перестает быть главной метрикой качества. Для бизнеса гораздо выгоднее подождать результат работы агента пару минут, если это снижает стоимость задачи в несколько раз.