Как сохранение истории рассуждений утроило результаты GPT-5.6 в тесте ARC-AGI-3
Исследователи выяснили, что низкие результаты передовых ИИ-моделей в бенчмарках часто связаны не с их внутренними ограничениями, а с потерей контекста и истории прошлых действий в тестовой среде.
Суть
Недавние тесты модели GPT-5.6 Sol в бенчмарке ARC-AGI-3 показали неожиданно низкие результаты. Однако исследователи выяснили, что проблема крылась не в способностях самой модели, а в настройках тестовой среды. Включение всего двух параметров — сохранения рассуждений (retained reasoning) и сжатия контекста (compaction) — позволило утроить итоговый балл и сократить количество генерируемых токенов в шесть раз. Это событие наглядно демонстрирует, как сильно техническая «обвязка» влияет на производительность искусственного интеллекта.
Контекст
Бенчмарк ARC-AGI-3 создан для оценки того, как агенты обучаются и мыслят. В нем искусственному интеллекту предлагается исследовать незнакомые 2D-головоломки и понимать их правила без явных инструкций. Изначально GPT-5.6 Sol набрал в этом тесте лишь 7,8%, хотя ранее успешно справлялся с более сложными задачами, включая математические гипотезы и прохождение игр вроде Pokémon FireRed.
Причина столь низкого результата крылась в архитектуре официальной тестовой среды (harness) ARC-AGI-3. Она была намеренно сделана максимально простой и универсальной. После каждого действия среда удаляла все скрытые рассуждения модели, заставляя ее каждый раз анализировать игру с нуля. Кроме того, использовалось скользящее усечение (rolling truncation) — по мере роста истории старые действия просто стирались из памяти.
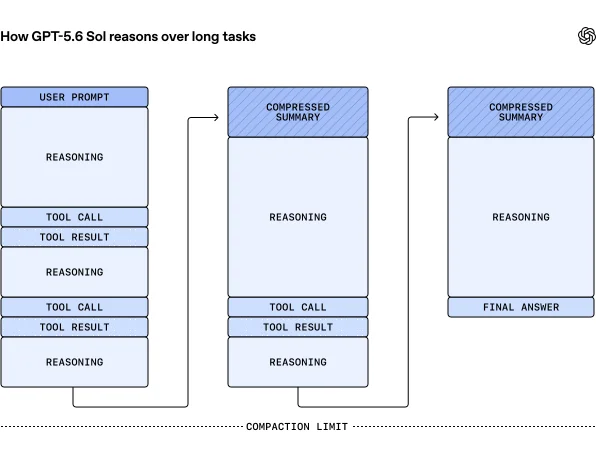
Diagram showing how model reasoning, tool calls, conversation history, and context compaction work together across a long-running task.
Детали
Чтобы исправить ситуацию, разработчики применили собственный интерфейс программирования приложений (API), который используется в реальных продуктах вроде ChatGPT и Codex.
Во-первых, они включили функцию сохранения рассуждений. Модели обучаются мыслить в скрытых сообщениях перед тем, как выдать ответ. Когда GPT-5.6 Sol позволили «помнить» свои прошлые планы и выводы, время на обдумывание каждого нового шага резко сократилось. Модель начала применять последовательные стратегии.
Во-вторых, скользящее усечение заменили на сжатие (compaction). Вместо того чтобы безвозвратно удалять старые данные при достижении лимита в 175 000 символов, система начала эффективно сжимать историю, сохраняя ключевые знания об игре.
В результате на публичном наборе данных ARC-AGI-3 оценка GPT-5.6 Sol выросла с 13,3% до 38,3%. Для сравнения, средний результат человека-тестировщика в этих задачах составляет около 48%.
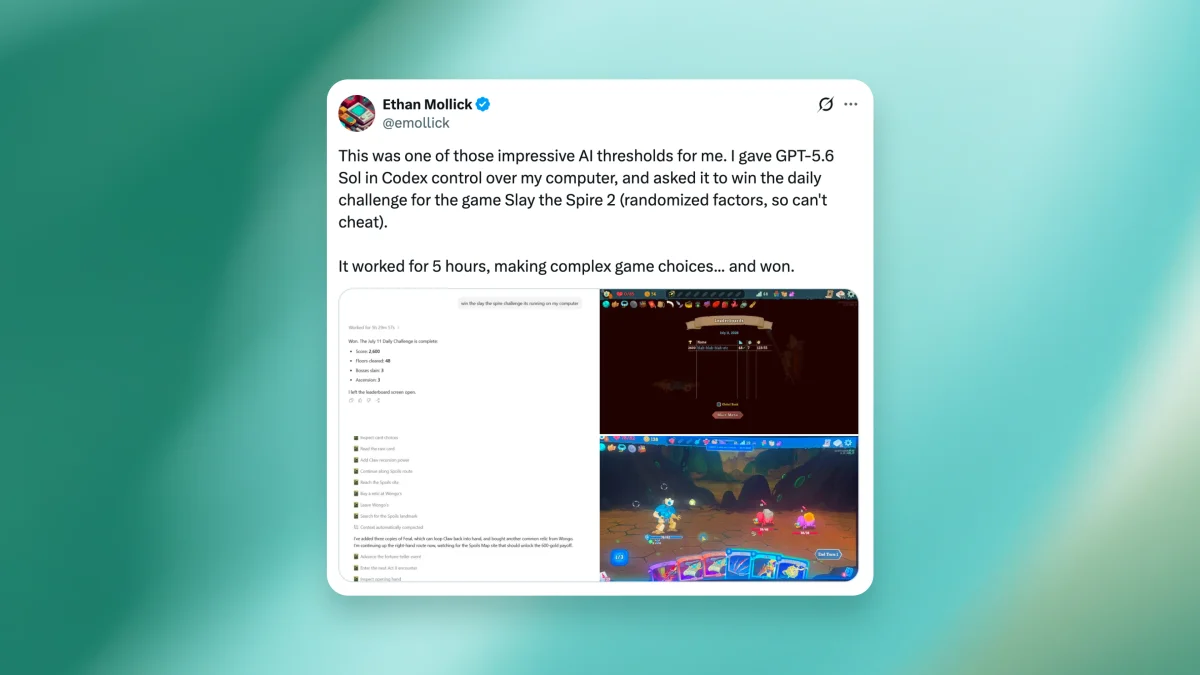
GPT-5.6 Sol in Codex completing a randomized daily challenge in Slay the Spire 2.
Анализ
Этот случай подчеркивает важную методологическую проблему в индустрии. Синтетические тесты (бенчмарки) редко измеряют возможности модели в вакууме. Они всегда оценивают комбинацию самой нейросети, настроек API, структуры тестовой среды и качества подсказок (промптов).
Когда мы лишаем ИИ-модель ее «внутреннего монолога» и памяти о прошлых ошибках, мы искусственно занижаем ее интеллектуальный потенциал. Агенты работают лучше всего тогда, когда могут опираться на свой предыдущий опыт, точно так же, как это делают люди.
Перспектива
Для разработчиков, создающих приложения на базе больших языковых моделей (LLM), это четкий сигнал: правильное управление контекстом критически важно. Использование современных методов сжатия памяти и сохранение цепочек рассуждений становится стандартом для создания по-настоящему автономных и умных агентов.
В будущем мы, вероятно, увидим пересмотр многих популярных бенчмарков. Оценивать передовые модели придется в условиях, которые максимально точно отражают их реальное использование в коммерческих продуктах, а не в искусственно ограниченных лабораторных средах.
oai Science Academic Research Academic Research 1x1
GPT-Red art card
TL;DR
Главное
Оценка способностей ИИ зависит не только от самой модели, но и от настроек памяти: сохранение истории рассуждений способно кратно повысить эффективность решения задач.
Ключевые факты
- /Результат GPT-5.6 в тесте ARC-AGI-3 вырос с 13,3% до 38,3%.
- /Количество генерируемых токенов сократилось в 6 раз.
- /Для улучшения использовались две настройки: сохранение рассуждений и сжатие контекста.
- /Официальная тестовая среда удаляла внутреннюю логику ИИ после каждого шага.
Инсайт
Слабые результаты передовых нейросетей в тестах часто вызваны тем, что тестовые среды заставляют их «забывать» свой внутренний монолог, заставляя решать проблему с нуля на каждом шаге.