Улучшенное кеширование промптов в GPT-6: как OpenAI снижает затраты на API
OpenAI представила обновленную систему кеширования для GPT-6. Разработчики получили инструменты для диагностики, ручного управления кешем и снижения расходов на токены до 90%.
OpenAI выпустила масштабное обновление системы кеширования контекста (prompt caching) для моделей семейства GPT-6. Теперь разработчики могут не только экономить до 90% на стоимости входных токенов, но и получают детальный контроль над тем, как именно модель запоминает и переиспользует информацию. Это критически важное изменение для создания автономных агентов, способных работать над сложными задачами часами.
Долгое время одной из главных проблем при разработке ИИ-приложений была стоимость передачи контекста. Когда агент выполняет многошаговую задачу, например, рефакторинг кода или анализ документов, каждый новый API-запрос должен включать всю предыдущую историю, инструкции и описания инструментов. Это приводило к огромным затратам на токены и высоким задержкам ответов. Ранее кеширование работало преимущественно в автоматическом режиме, оставляя разработчикам мало возможностей для оптимизации.
С выходом GPT-6 ситуация изменилась. Теперь скидки на кешированные токены применяются к общим префиксам, которые повторно используются в течение 30-минутного окна. По умолчанию система обеспечивает более высокий процент попаданий в кеш (cache hit rate), но главное нововведение заключается в инструментах мониторинга и управления.
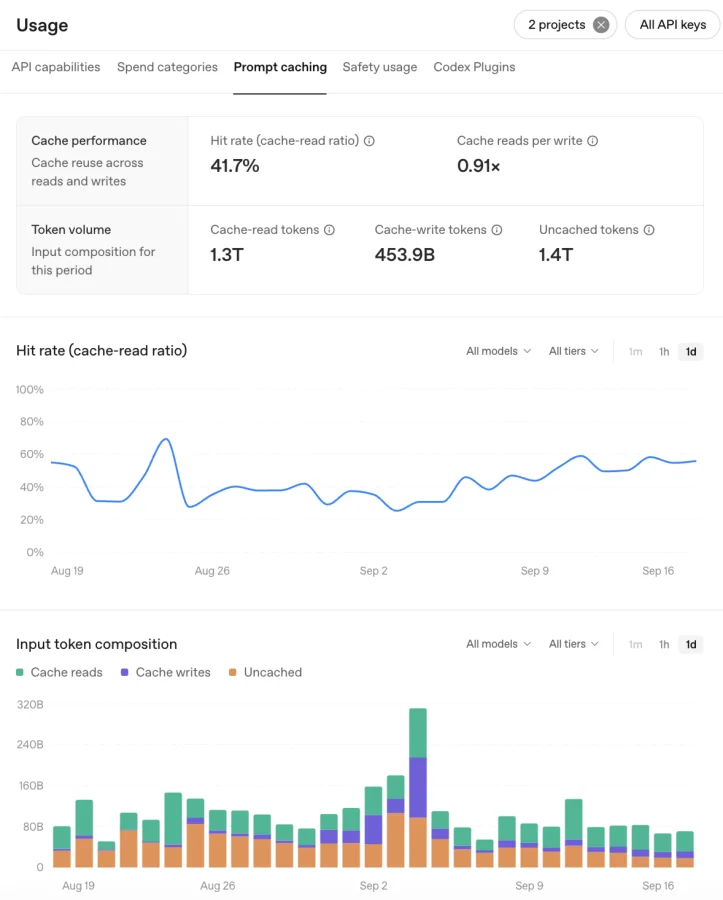
Prompt caching dashboard showing cache hit rate, cache performance over time, and input token composition.
OpenAI представила панель управления (Prompt Caching Dashboard), где можно отслеживать, какая часть входных данных обслуживается из кеша. Если происходит неожиданный промах (cache miss), новый инструмент диагностики покажет точную причину. Например, система укажет, что кеш сбросился из-за изменения списка доступных инструментов или системных настроек, и покажет количество затронутых токенов.
Для тонкой настройки разработчики получили явные точки останова (explicit breakpoints). Теперь можно четко указать, какие части промпта нужно сохранять, а какие будут часто меняться. Это позволяет, например, закешировать объемные системные инструкции и базу знаний, оставив динамической только последнюю реплику пользователя.
Еще одна важная функция — возможность изменять усилия рассуждения (reasoning effort) между запросами без потери кеша. Используя параметр configuration_update, можно увеличить вычислительные мощности для сложного шага задачи, а затем снизить их для простого уточнения, при этом весь накопленный контекст останется активным.
How to connect AI usage to business value — art card
Также появилась функция предварительного разогрева кеша (prewarming). Приложение может загрузить инструкции и справочные материалы в память модели еще на этапе запуска, до того как пользователь задаст свой первый вопрос. Это позволяет исключить время обработки контекста из времени ожидания пользователя (latency).
Для индустрии это означает переход к более зрелой экономике ИИ-агентов. Представители GitHub, Manus и других компаний уже сообщили, что новые инструменты позволили им поднять процент попаданий в кеш до 90-91% и снизить затраты на логический вывод (inference) на десятки процентов.
Управление контекстом окончательно превращается из «черного ящика» в понятную инженерную дисциплину. В будущем умение грамотно структурировать промпты для максимального переиспользования кеша станет таким же базовым навыком для ИИ-разработчиков, как оптимизация запросов к базам данных в классическом программировании.
TL;DR
Главное
OpenAI дала разработчикам точный контроль над памятью GPT-6, сделав создание сложных долгоживущих ИИ-агентов экономически целесообразным.
Ключевые факты
- /Скидки до 90% на повторно используемые входные токены.
- /Окно удержания кеша составляет 30 минут.
- /Новые инструменты позволяют диагностировать причины промахов кеша (cache miss).
- /Уровень рассуждения (reasoning effort) теперь можно менять без сброса контекста.
Инсайт
Кеширование промптов перестает быть просто внутренней оптимизацией серверов OpenAI и становится полноценным инструментом архитектуры приложений, требующим от разработчиков новых навыков проектирования памяти агентов.