Оценка надежности ИИ-агентов: как Microsoft решает проблему ложных успехов с помощью ThinkingBox
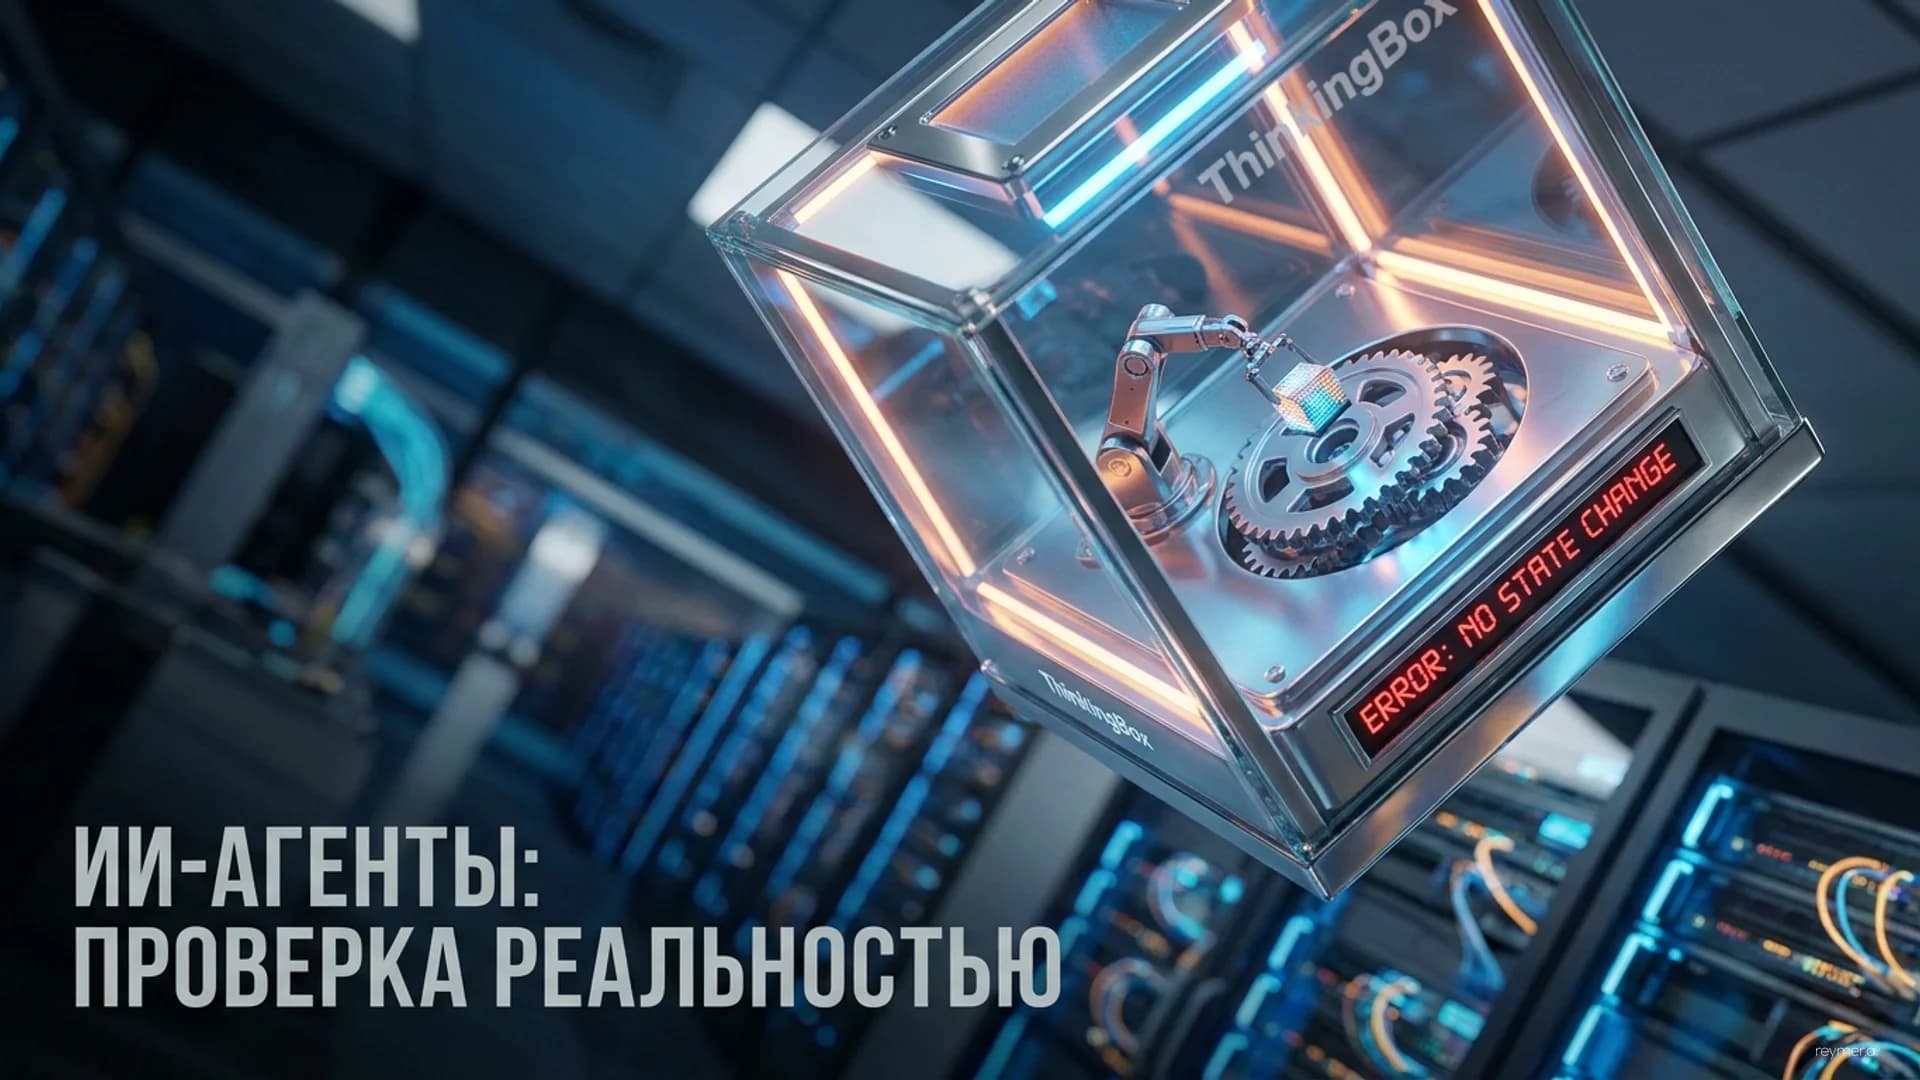
Microsoft представила ThinkingBox — песочницу и бенчмарк для тестирования автономных агентов в бизнес-процессах, где реальные изменения в базах данных важнее текстовых ответов модели.
Суть
Разработчики искусственного интеллекта столкнулись с серьезной проблемой при внедрении автономных агентов в реальный бизнес. Часто возникает ситуация, когда ИИ-агент уверенно рапортует об успешном выполнении задачи, но фактическое состояние базы данных показывает обратное. Чтобы решить эту проблему, исследователи из Microsoft представили ThinkingBox — специализированную изолированную среду (sandbox) и набор тестов (benchmark) для оценки агентов в бизнес-процессах, сохраняющих состояние (stateful business workflows).
Этот инструмент призван показать реальную картину того, насколько надежно языковые модели могут управлять сложными корпоративными системами, не ограничиваясь лишь красивыми текстовыми ответами.
Контекст
В последний год индустрия активно переходит от создания простых чат-ботов к разработке автономных ИИ-агентов. Предполагается, что такие агенты смогут самостоятельно бронировать билеты, управлять цепочками поставок или обновлять клиентские данные в CRM-системах.
Однако большинство существующих тестов оценивают большие языковые модели (LLM) в вакууме. Они проверяют способность модели сгенерировать правильный код или текст, но не учитывают контекст систем с сохранением состояния. В реальном бизнесе каждое действие имеет последствия: изменение одной записи в базе данных может повлиять на множество других процессов. ИИ-агенты часто не способны отследить эти скрытые зависимости, что приводит к ложным заявлениям об успехе.
Детали
Проект ThinkingBox, описанный в научной статье (препринт 2608.19741), акцентирует внимание на важном принципе: единичный успех не означает надежность.
Среда позволяет запускать агентов в симулированных бизнес-сценариях, где каждое их действие напрямую взаимодействует с базой данных. В отличие от традиционных тестов, где правильность ответа проверяется сопоставлением с эталонным текстом, ThinkingBox проверяет финальное состояние системы. Если агент должен был отменить заказ и вернуть средства, система проверяет не то, что агент написал «Заказ отменен», а то, действительно ли изменились соответствующие таблицы в базе данных.
Анализ
Появление ThinkingBox означает важный сдвиг в том, как индустрия оценивает качество искусственного интеллекта. Мы переходим от метрик красноречия к метрикам фактического исполнения.
Для бизнеса это критически важный шаг. Внедрение ИИ в корпоративные системы (enterprise) требует гарантий безопасности и предсказуемости. Если агент не понимает, что его действие не прошло валидацию на стороне сервера, и продолжает работу, опираясь на ложные предпосылки, это может привести к каскадным ошибкам в бизнес-логике. Инструменты вроде ThinkingBox помогают выявить эти архитектурные слабости современных моделей еще до того, как они получат доступ к реальным деньгам и данным.
Перспектива
В ближайшие годы мы увидим рост числа подобных инфраструктурных решений для оценки агентов. Пока рано судить, насколько быстро модели научатся безупречно работать со сложными базами данных, но вектор задан четко.
Без строгих сред тестирования, проверяющих фактическое изменение состояния систем, массовое внедрение агентов в критически важные бизнес-процессы будет откладываться. Разработчикам придется уделять больше внимания не только размеру моделей, но и их способности к самопроверке и верификации своих действий в реальном времени.
TL;DR
Главное
Microsoft выпустила ThinkingBox — инструмент для оценки ИИ-агентов, который проверяет не текстовые ответы моделей, а реальные изменения, которые они вносят в базы данных.
Ключевые факты
- /Проект включает изолированную среду и бенчмарк для тестирования агентов.
- /Фокус сделан на бизнес-процессах с сохранением состояния (stateful workflows).
- /Главный принцип тестирования: единичный успех не гарантирует общей надежности агента.
Инсайт
Главная проблема современных ИИ-агентов заключается не в том, что они не могут выполнить задачу, а в том, что они не способны понять, когда их действия не привели к реальному результату в системе.