
Опыт Warp: как создать самообучающихся ИИ-агентов с помощью системы навыков
Разработчики терминала Warp решили проблему потери контекста у ИИ-агентов, внедрив простую архитектуру из двух навыков и непрерывного цикла обратной связи.
Warp, разработчик популярного терминала со встроенным искусственным интеллектом, поделился архитектурой создания самообучающихся ИИ-агентов на базе платформы Claude. Суть подхода заключается в использовании текстовых файлов для хранения знаний агента и автоматическом их обновлении на основе отзывов пользователей. Это позволяет агентам накапливать опыт, а не начинать каждую сессию с чистого листа.
Проблема большинства текущих ИИ-инструментов — отсутствие памяти между рабочими сессиями (stateless). Когда агент выполняет задачу, например, проверяет код, он опирается на базовую инструкцию. Если инструкция решает задачу на 80%, оставшиеся 20% ошибок создают информационный шум. Инженер может поправить агента в чате, но в следующем сеансе контекст исчезнет, и ошибка повторится. Ручное переписывание системных инструкций (промптов) на основе жалоб пользователей быстро перестает масштабироваться.
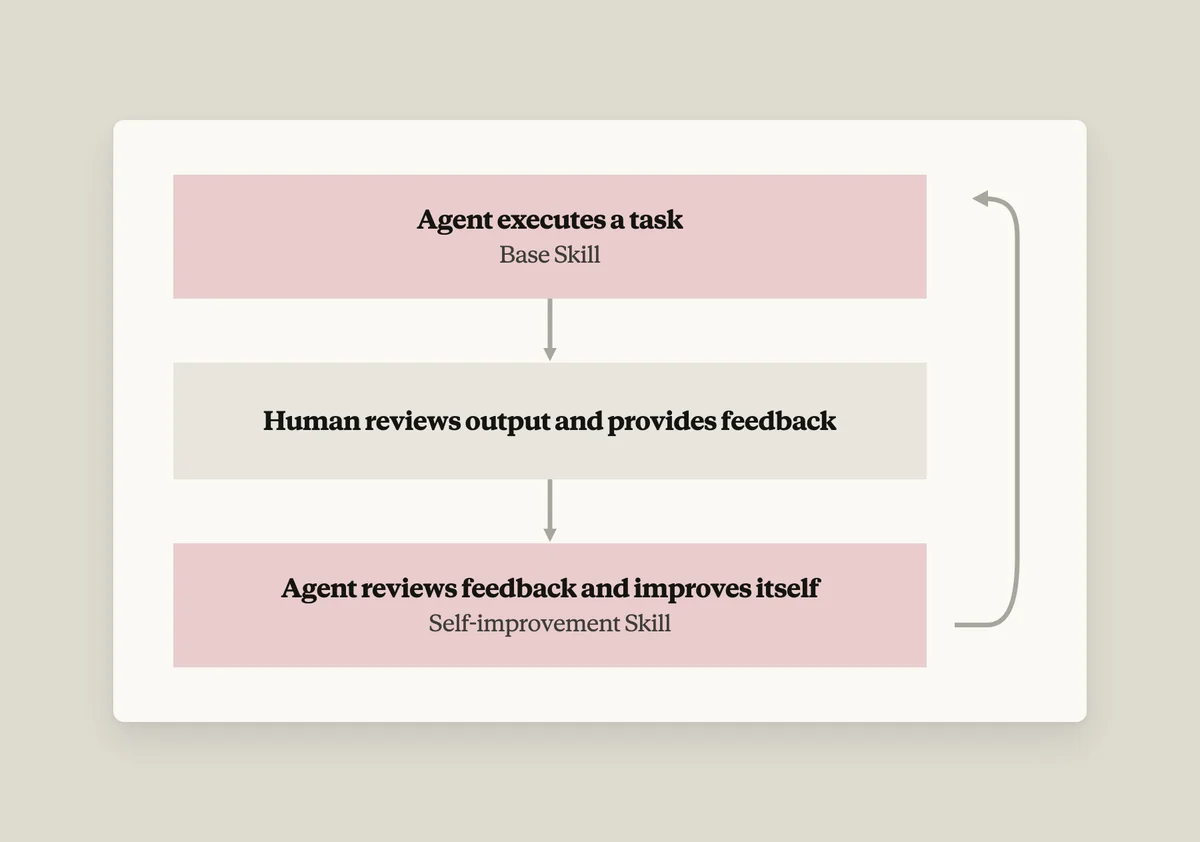
Решение, к которому пришли инженеры Warp, опирается на систему из двух компонентов: базового навыка (inner skill) и навыка-улучшателя (outer skill).
Базовый навык содержит доменные знания и инструкции для конкретной задачи. Навык-улучшатель функционирует как агент-наблюдатель. Он работает по расписанию, собирает комментарии людей, анализирует расхождения между ответом базового агента и ожиданием разработчика, а затем предлагает точечные изменения в файл базового навыка.
На практике это выглядит так. В репозитории Warp работает агент сортировки задач (issue triage). Однажды он пропустил важный ярлык при анализе новой проблемы. Разработчик оставил комментарий прямо в GitHub, объяснив, почему ярлык был необходим. Агент-улучшатель автоматически собрал этот отзыв, сформулировал новое правило и создал запрос на изменение кода (Pull Request) в файл базового навыка. Человек проверил логику, одобрил изменения, и при следующем запуске агент уже обладал новыми знаниями.
Изображение из источника
Этот подход элегантно решает проблему деградации контекста. Вместо того чтобы пытаться загрузить все возможные правила в один гигантский промпт, знания кодируются инкрементально. Основатель Warp Зак Ллойд (Zach Lloyd) выделяет несколько ключевых принципов создания таких систем:
Во-первых, нужно писать принципы, а не жесткие правила. Инструкции должны звучать как советы компетентному специалисту. Важно объяснять агенту причину правила (почему нужно делать именно так), чтобы модель могла обобщать знания, а не слепо следовать алгоритму.
Во-вторых, сбор обратной связи должен быть естественным. Пользователи не будут заполнять отдельные формы. Отзывом должен служить обычный рабочий процесс: комментарий к коду или обсуждение задачи.
В-третьих, качество обратной связи важнее объема. Один развернутый комментарий от старшего инженера с объяснением контекста дает системе больше пользы, чем сотни бинарных оценок (лайк/дизлайк), которые не объясняют суть ошибки.
Переход от разовых помощников к системам, знания которых накапливаются (compound effect) со временем — это следующий логичный шаг в развитии корпоративного ИИ. Подход Warp наглядно показывает, что для создания самообучающихся систем не обязательно строить сложные архитектуры с нуля. Достаточно правильной организации рабочих процессов, использования больших языковых моделей (LLM) для анализа текста и сохранения контроля за изменениями в руках человека.
TL;DR
Главное
Warp превратил разовые отзывы пользователей в непрерывный цикл улучшения ИИ-агентов, используя текстовые файлы навыков вместо усложнения системных инструкций.
Ключевые факты
- /Архитектура состоит из базового навыка (выполнение задачи) и навыка-улучшателя (анализ отзывов).
- /Обновления навыков происходят через стандартные Pull Requests, оставляя финальный контроль за человеком.
- /Качественный текстовый комментарий с объяснением причины ошибки полезнее для обучения агента, чем бинарные оценки.
Инсайт
Создание агента-наблюдателя (навыка-улучшателя) требует наибольших первоначальных усилий, но этот механизм универсален и легко переносится на любые другие задачи внутри компании.


