Оценка Claude Fable 5 на сложных задачах программирования: опыт команды Cursor
Команда Cursor протестировала модель Claude Fable 5 на собственных внутренних бенчмарках. Результаты показывают переход ИИ-агентов от локального решения проблем к пониманию архитектуры проекта.
Команда разработчиков среды программирования Cursor опубликовала результаты внутреннего тестирования новой модели Claude Fable 5 от компании Anthropic. Инженер Нейт Шмидт, отвечающий за оценку поведения алгоритмов, отметил качественный сдвиг в возможностях искусственного интеллекта. Модель продемонстрировала способность не просто генерировать код по четкой инструкции, но и понимать глобальный контекст инженерной задачи. Это важное событие для индустрии, так как оно знаменует переход от базовых ИИ-помощников к более автономным агентам.
В последние месяцы исследователи начали замечать проблему: высокие оценки моделей в публичных тестах производительности (benchmarks) перестали совпадать с реальным опытом разработчиков. В лабораторных условиях искусственный интеллект получает четко сформулированную задачу со всеми ограничениями. В реальности программисты часто отправляют в чат фрагмент журнала ошибок (stack trace) с единственным словом «исправь».

Изображение из источника
Чтобы объективно оценивать алгоритмы, команда создала CursorBench. Это внутренний набор оценок (evaluations), имитирующий хаотичную работу живых людей. Например, в одном из тестов модели специально указывают на неверный модуль, чтобы проверить, пойдет ли она по ложному следу или оспорит предположение пользователя. В этих жестких условиях Claude Fable 5 достигла показателя успешности 72,9% при максимальных настройках вычислительных усилий, установив новый рекорд.
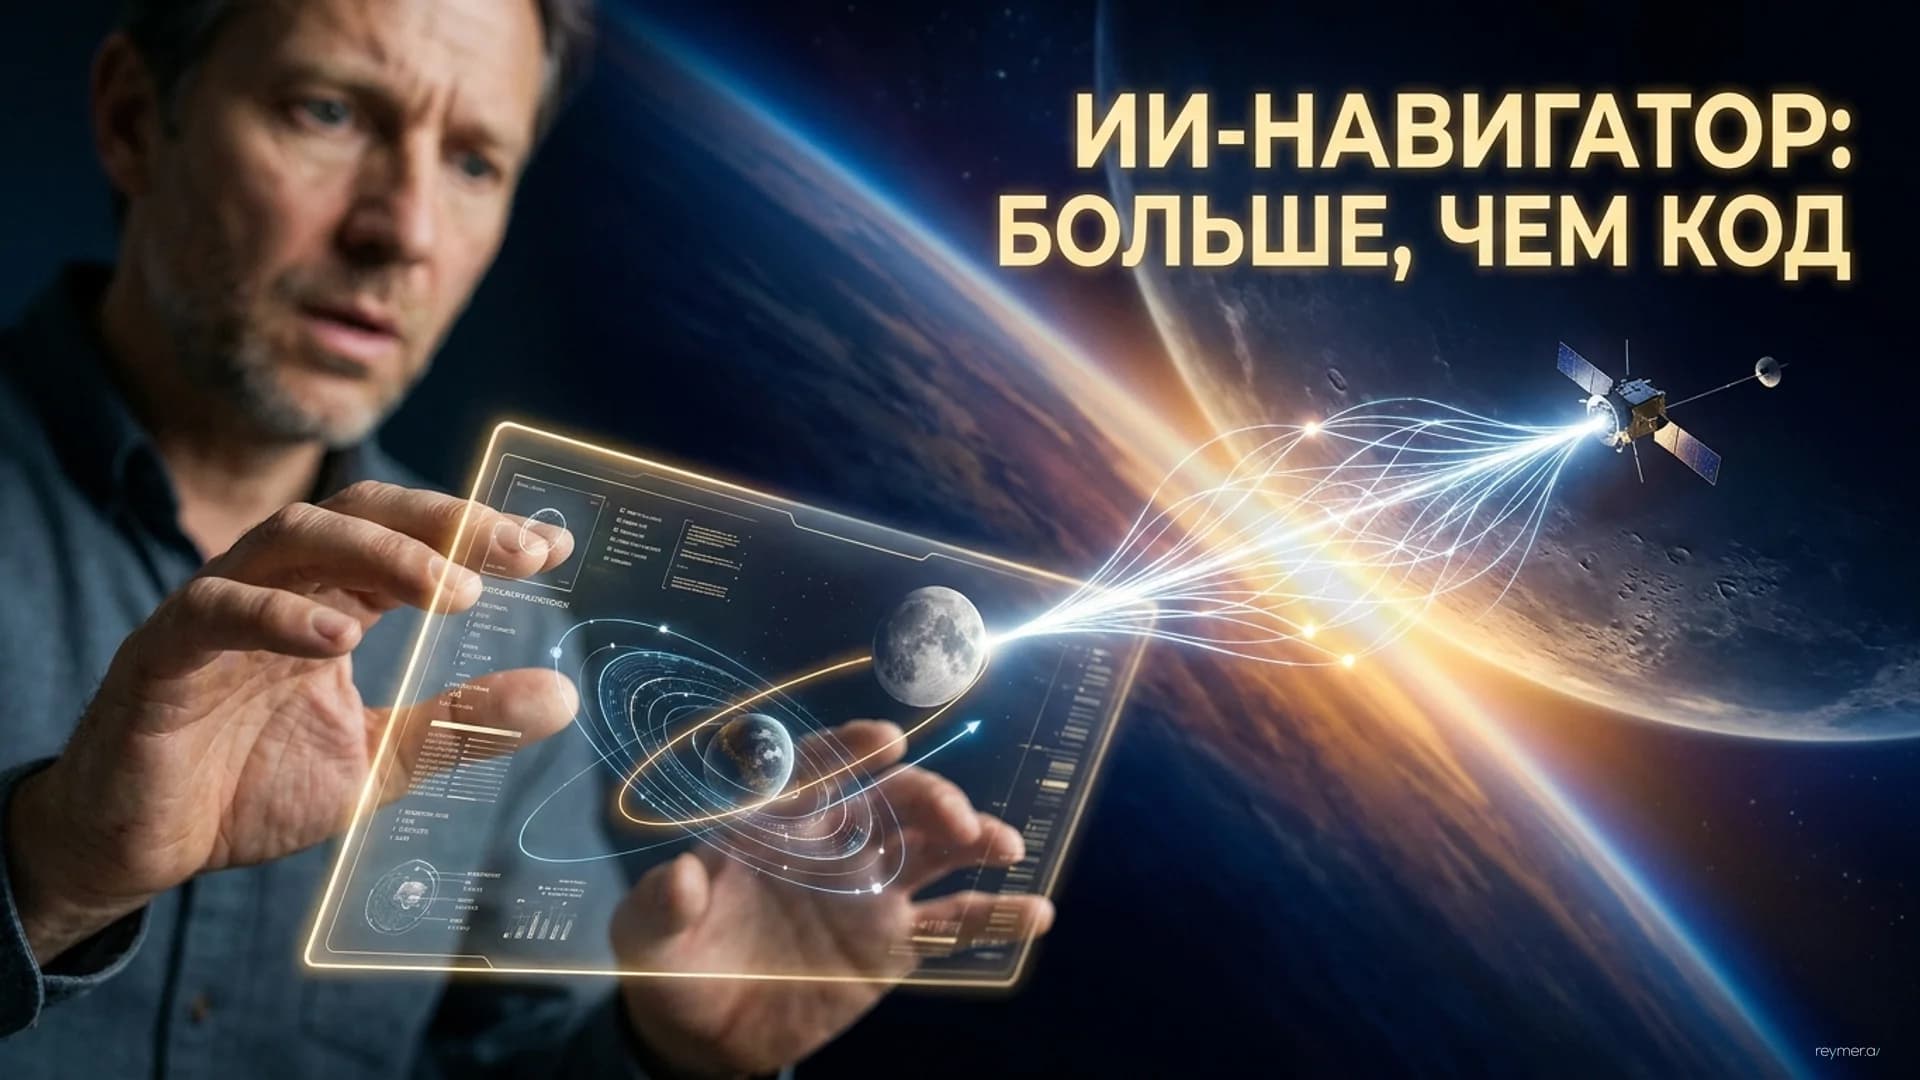
Главное отличие новой модели заключается в переходе от локального к глобальному рассуждению (global reasoning). Шмидт иллюстрирует это экспериментом с программируемым симулятором космических полетов. При задаче «построить ракету и посадить ее на Луну» предыдущая модель, Claude Opus, пыталась решить проблему прямым перебором. Она постоянно добавляла топливо, делая ракету слишком тяжелой, и тратила на безуспешные попытки более 12 часов.

Изображение из источника
Claude Fable 5 подошла к задаче иначе. Изучив журнал действий, инженер обнаружил, что алгоритм самостоятельно решил отложить посадку на Луну при первой попытке. Вместо этого он провел тестовый запуск на околоземную орбиту для сбора телеметрии, чтобы использовать эти данные для следующего этапа. Успешная посадка заняла всего пару часов. Модель мыслила категориями всей миссии, а не только следующего шага.
Для команд разработки такие возможности меняют сам подход к планированию. Появляется возможность браться за сложные задачи вроде глубокого изменения структуры кода (refactoring), которые раньше откладывались из-за нехватки времени. ИИ способен самостоятельно удерживать в памяти архитектурный каркас решения. Кроме того, меняется формат взаимодействия: автономные агенты могут анализировать код коллег и предупреждать о возможных конфликтах до того, как разработчики начнут интеграцию изменений.
Чтобы оптимизировать расходы, инженеры используют быстрые и дешевые модели для рутинных задач, подключая Claude Fable 5 только там, где требуется глубокое понимание системы. В ближайшем будущем планируется протестировать способность модели автономно управлять серверной инфраструктурой (back-end) в течение нескольких дней или недель. Успех в этом направлении откроет путь к созданию систем, которые будут проактивно находить узкие места в производительности, не дожидаясь отчетов об ошибках от пользователей.

Изображение из источника
TL;DR
Главное
Модель Claude Fable 5 продемонстрировала способность к глобальному планированию при написании кода, значительно снизив необходимость в постоянном контроле со стороны разработчика.
Ключевые факты
- /Модель набрала 72,9% в сложном внутреннем тесте CursorBench.
- /CursorBench оценивает реальные сценарии, включая неполные или намеренно ошибочные запросы пользователей.
- /В тесте с симулятором полетов модель самостоятельно решила провести сбор телеметрии на орбите перед финальной посадкой на Луну.
Инсайт
Главная ценность новых ИИ-моделей заключается не в скорости генерации строк кода, а в способности оспаривать неверные предположения пользователя и самостоятельно находить реальный корень проблемы.