Руководство по выбору моделей Claude: баланс между стоимостью и эффективностью
Разбор линейки моделей от Anthropic: от базового Haiku до экспериментального Mythos. Почему стоимость за задачу важнее цены за токен и как правильно тестировать ИИ в корпоративной среде.
Суть
Anthropic поделилась методологией выбора моделей из семейства Claude для различных рабочих нагрузок. Главный вывод компании заключается в том, что разработчикам следует ориентироваться на итоговую стоимость решения конкретной задачи, а не на номинальную цену за тысячу сгенерированных токенов.
Контекст
С развитием генеративного искусственного интеллекта линейки больших языковых моделей (LLM) усложняются. Если раньше выбор ограничивался одной-двумя версиями, то теперь экосистема включает множество вариантов, адаптированных под разный уровень сложности, безопасности и бюджета. Пользователи часто совершают ошибку, пытаясь подобрать модель под конкретную индустрию, например, исключительно для финансов или медицины. Разработчики подчеркивают, что все их модели универсальны, а фундаментальная разница кроется лишь в способности справляться с многошаговыми и нестандартными проблемами.
Изображение из источника
Детали
Семейство Claude в актуальном виде включает несколько классов, каждый из которых решает определенный спектр задач:
- Mythos и Fable: Флагманский уровень с передовыми возможностями в программировании и управлении автономными агентами. Версия Mythos доступна только узкому кругу организаций для исследований в области кибербезопасности и биологии. Версия Fable предназначена для широкой публики и включает строгие фильтры безопасности.
- Opus: Мощный инструмент для задач, требующих сложного логического вывода в корпоративной среде. Интересно, что при схожих результатах в синтетических тестах, более крупные модели вроде Fable демонстрируют большую креативность по сравнению с Opus.
- Sonnet: Универсальная модель для массовых повседневных задач и оркестровки агентов, предлагающая оптимальный баланс скорости и цены.
- Haiku: Самая быстрая и доступная модель для высокочастотных операций, где критична минимальная задержка ответа.
Анализ
Изображение из источника
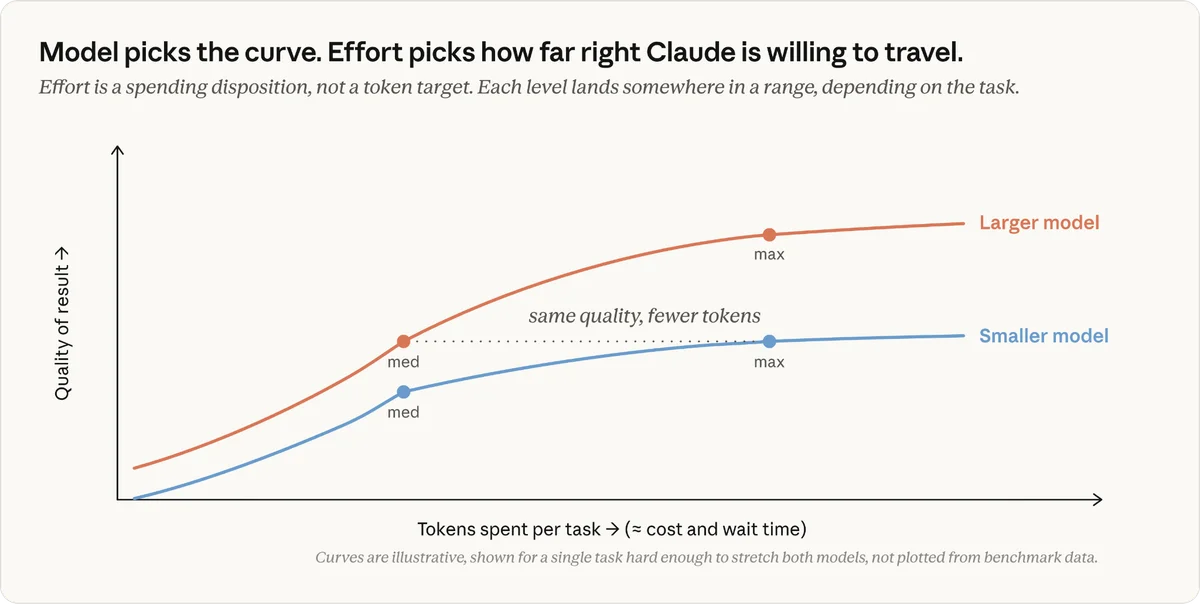
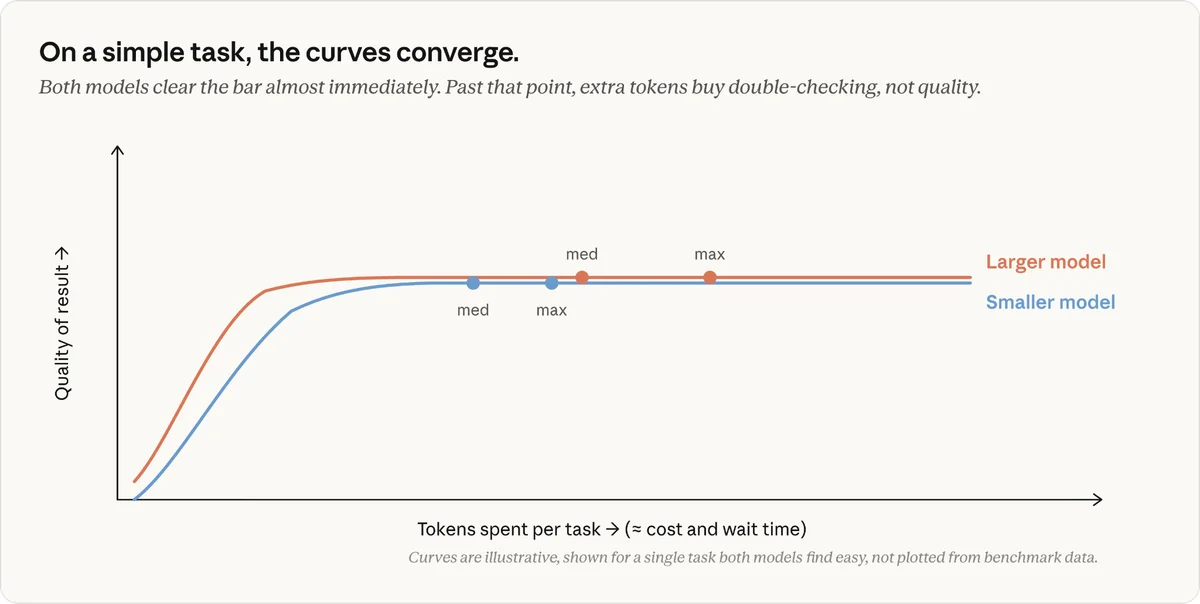
Ключевой совет от создателей Claude — начинать разработку с самой мощной из доступных моделей. На первый взгляд это противоречит логике экономии, но на практике продвинутые алгоритмы справляются с задачей за меньшее количество итераций. В результате итоговая стоимость выполнения задачи часто оказывается ниже.
Дополнительную гибкость дает архитектурный паттерн "советник" (advisor strategy). В рамках этого подхода недорогая модель-исполнитель (например, Sonnet) обращается к более мощной модели (Fable) только для проверки плана действий. Внутренние тесты показывают, что такая связка позволяет получить качество, близкое к флагманскому, потратив лишь 63% от стандартной стоимости использования старшей модели.
Перспектива
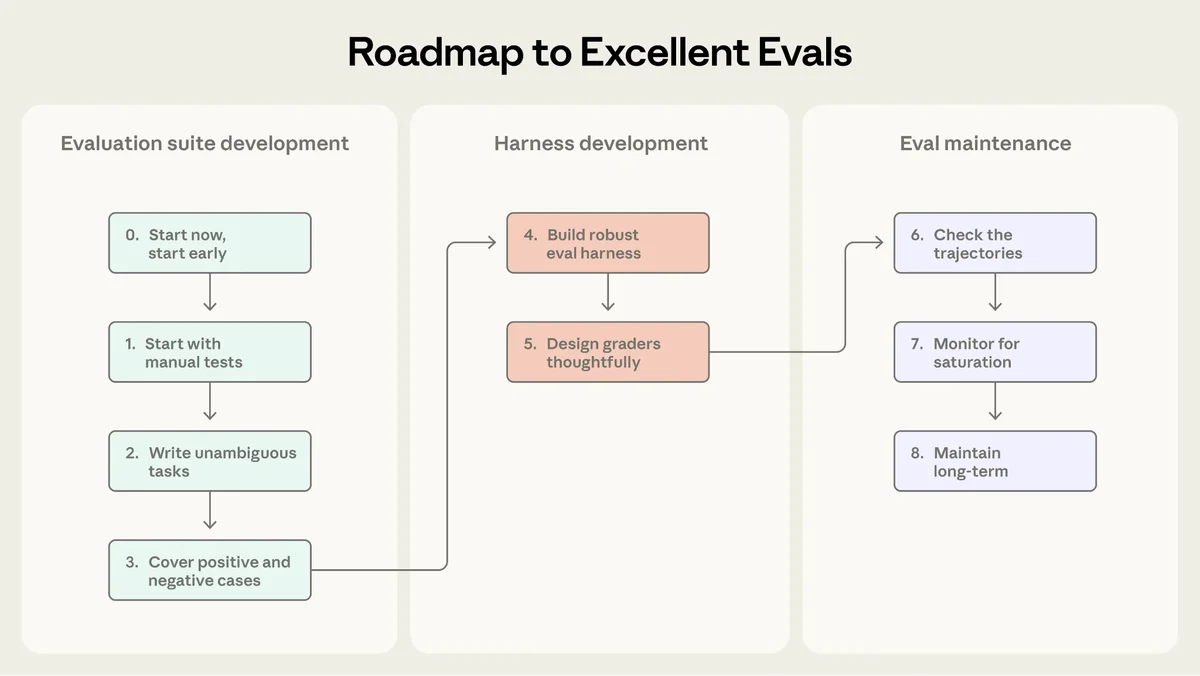
Стандартные индустриальные тесты (бенчмарки) стремительно теряют свою полезность для оценки передовых ИИ. Современные модели достигают в них эффекта насыщения, решая подавляющее большинство задач без ошибок. В ближайшем будущем единственным надежным способом выбора модели станут внутренние системы оценки (evaluations), построенные на реальных данных конкретного бизнеса. Компаниям придется сместить фокус с изучения публичных рейтингов на создание собственных инструментов тестирования качества, чтобы эффективно управлять затратами на искусственный интеллект.
Изображение из источника
TL;DR
Главное
Выбор модели ИИ зависит от сложности задачи, а не от специализации. Начинать разработку выгоднее с самых мощных моделей, так как они требуют меньше шагов для достижения результата.
Ключевые факты
- /Линейка Claude включает уровни: Mythos/Fable, Opus, Sonnet и Haiku.
- /Модель Mythos доступна только доверенным организациям для работы с биологией и кибербезопасностью.
- /Стратегия "советника" (комбинация быстрой и умной моделей) экономит до 37% бюджета на генерацию.
- /Публичные бенчмарки теряют смысл из-за эффекта насыщения — топовые модели решают их почти без ошибок.
Инсайт
Оценка стоимости работы ИИ по цене за тысячу токенов устарела. Гораздо важнее считать стоимость решения всей задачи целиком, так как дорогие интеллектуальные модели тратят меньше времени и итераций на правильный ответ.