Liquid AI представляет LFM3: мультимодальные модели на единой архитектуре для граничных устройств
Liquid AI выпустила третье поколение своих базовых моделей (LFM3) в классе 2 миллиардов параметров. Новая архитектура объединяет текст, зрение, аудио и принятие решений на одном ядре, оптимизирована для работы на устройствах (edge) и поддерживает контекст до 256 тысяч токенов.
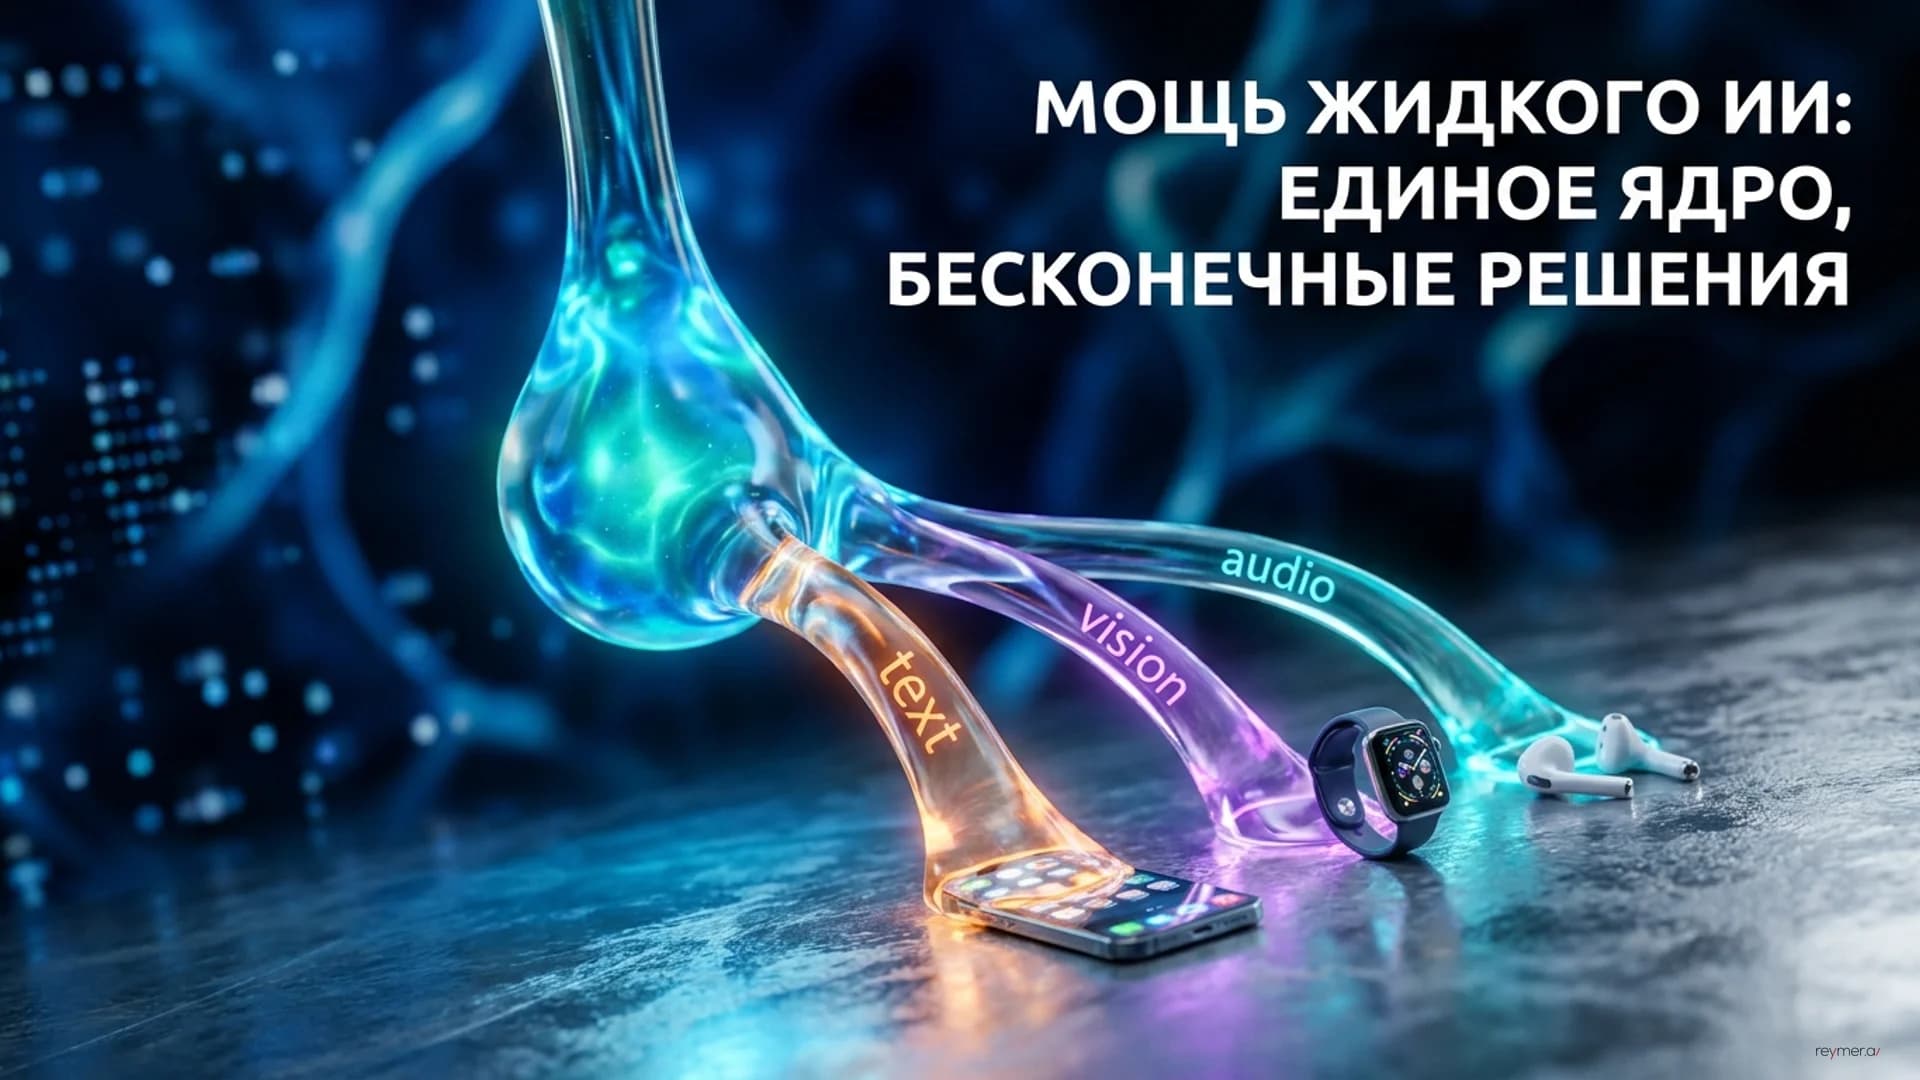
Liquid AI представила третье поколение своих базовых моделей (Liquid Foundation Models) — семейство LFM3. Главная особенность релиза заключается в создании единой архитектуры для шести специализированных моделей в классе 2 миллиардов параметров. На одном базовом ядре теперь работают текстовые, визуальные, звуковые, мультимодальные (omni) модели и модели принятия решений.
Исторически разработка мультимодальных систем часто шла по пути склеивания разнородных архитектур. Liquid AI пошла другим путем: компания создала единую основу, LFM3-1.7B-Base, от которой ответвляются специализированные версии. Это позволяет пользователю выбрать нужную модальность, дообучить ее на одном графическом процессоре (GPU) и развернуть непосредственно на конечном устройстве, будь то смартфон или Raspberry Pi 5.
Базовая модель LFM3-1.7B-Base была обучена на 22 триллионах токенов. Последние 3,5 триллиона токенов составили этап промежуточного обучения на тщательно отобранных данных с большой долей агентских задач и вызовов инструментов. Это позволило расширить контекстное окно модели до 256 тысяч токенов.
Архитектура LFM3 претерпела значительные изменения по сравнению с предыдущим поколением. Инженеры применили аппаратный поиск архитектуры (hardware-in-the-loop architecture search), охвативший 14 комбинаций устройств и бэкендов, включая мобильные телефоны, Raspberry Pi 5, ноутбуки, облачные процессоры, GPU и нейронные процессоры Qualcomm Hexagon.
В результате базовая модель LFM3-1.7B получила 24 слоя с использованием «тройной гибридной» (tri-hybrid) структуры. Она включает 13 слоев стробированных коротких сверток (gated short convolutions) с размером ядра 7 (по сравнению с 3 в LFM2), 5 слоев внимания со скользящим окном (sliding-window attention) размером 256 токенов и 6 слоев глобального внимания. Также внедрено поглавное стробированное внимание (head-wise gated attention), позволяющее отключать головы внимания, когда им нечего добавить, что помогает при квантовании.
Эти изменения привели к повышению эффективности. По заявлению компании, LFM3-1.7B превосходит предыдущую модель LFM2.5-2.6B, используя на 35% меньше параметров. На коротких запросах новая модель работает на уровне LFM2-1.2B, а при контексте в 8 тысяч токенов оказывается примерно на 25% быстрее.
Семейство моделей включает в себя несколько специализированных версий. Текстовая модель LFM3-1.7B в 4-битном квантовании занимает около 1 ГБ памяти, что делает ее пригодной для локальных агентов. На бенчмарке WebArena-Verified она набирает 38.42 балла против 3.02 у предшественницы.
Визуальная модель LFM3-VL-2B стала первой в линейке LFM, способной принимать на вход видео. Она использует новый внутренний энкодер на 164 миллиона параметров, который требует в 2.2 раза меньше операций с плавающей запятой (FLOPs) по сравнению с энкодером Qwen3.5-2B при аналогичной точности. Модель набирает в среднем 71.4 балла на 62 визуальных бенчмарках (против 57.6 у LFM2.5-VL-3B).
Аудиомодель LFM3-Audio-2B получила новый каузальный аудиоэнкодер и кодек LiquidCodec. Модель способна начать генерацию первых токенов уже через 50 миллисекунд после начала речи пользователя. Декодирование сгенерированных токенов в речь происходит со скоростью, примерно в 87 раз превышающей реальное время на одном потоке процессора Apple M4 Max.
Стратегия Liquid AI демонстрирует смещение фокуса с создания гигантских универсальных моделей на разработку компактных, высокоэффективных и специализированных решений для граничных вычислений. Унификация архитектуры снижает барьер для внедрения сложных мультимодальных агентов на устройствах с ограниченными ресурсами.
TL;DR
Главное
Liquid AI выпустила семейство моделей LFM3 в классе 2B параметров, объединив текст, зрение, аудио и принятие решений на единой эффективной архитектуре, оптимизированной для локального запуска на устройствах.
Ключевые факты
- /Базовая модель LFM3-1.7B-Base обучена на 22 триллионах токенов и поддерживает контекст до 256 тысяч токенов.
- /LFM3-1.7B превосходит LFM2.5-2.6B, имея на 35% меньше параметров.
- /Текстовая модель в 4-битном формате занимает около 1 ГБ памяти.
- /Новый визуальный энкодер требует в 2.2 раза меньше FLOPs по сравнению с энкодером Qwen3.5-2B при той же точности.
Инсайт
Вместо создания одной огромной мультимодальной модели, Liquid AI сделала ставку на единое ядро, от которого ответвляются специализированные модели. Это позволяет разработчикам выбирать только нужный функционал и запускать его на слабых устройствах, экономя ресурсы.