Большие языковые модели автоматизируют масштабную формальную верификацию кода
Команда Anthropic в сотрудничестве с Theorem использовала модель Claude для математического доказательства безопасности 123 библиотек с открытым исходным кодом на уровне ассемблера.
Суть
Команда исследователей Anthropic (Frontier Red Team) совместно с компанией Theorem продемонстрировала, что большие языковые модели (LLM) способны масштабировать процесс формальной верификации программного обеспечения. Используя модель Claude, исследователи смогли математически доказать свойства безопасности на уровне ассемблерного кода (RISC-V) для более чем 100 реальных библиотек с открытым исходным кодом. В процессе написания доказательств модель также обнаружила и исправила ошибки, которые оставались незамеченными годами.
Контекст
Даже самое зрелое и тщательно протестированное программное обеспечение содержит уязвимости. Традиционные методы защиты и тестирования становятся недостаточными, особенно когда современные ИИ-модели учатся находить и объединять незначительные ошибки в критические эксплойты.
Идеальным решением является формальная верификация — процесс перевода кода в математическую модель для строгого доказательства того, что он всегда следует заданному набору правил безопасности. Если доказательство успешно, это гарантирует отсутствие определенных классов ошибок. Однако исторически этот процесс требовал колоссальных усилий узкопрофильных специалистов. Например, разработка ядра операционной системы seL4 заняла два человеко-года, а его формальная верификация — 20 человеко-лет. Из-за этого метод применялся только в критически важных системах, таких как авионика.
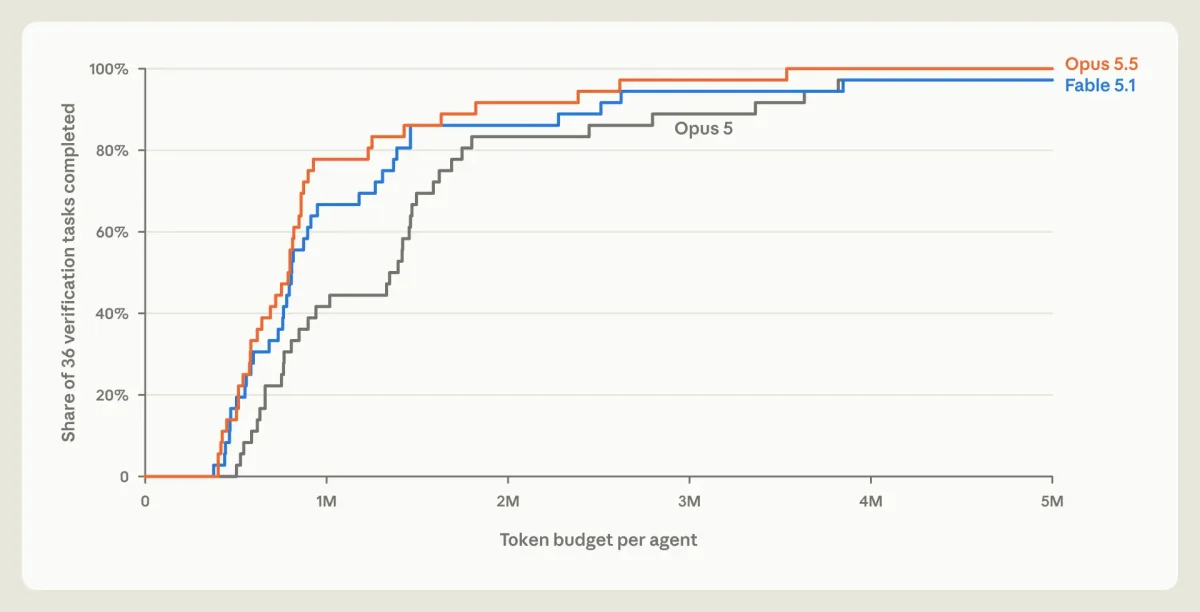
Line chart of the share of 36 verification tasks completed by token budget per agent for Opus 5.5, Fable 5.1, and Opus 5. Opus 5.5 finishes proofs with the fewest tokens.
Детали
В рамках проекта исследователи поставили перед Claude задачу доказать отсутствие сбоев в 123 библиотеках из инициативы Google OSS-Fuzz. OSS-Fuzz обычно использует фаззинг (fuzzing) — автоматизированную подачу огромного количества мутированных входных данных для поиска сбоев.
Вместо бесконечного перебора команда превратила сами фаззинг-тесты в спецификации. Модели нужно было доказать, что скомпилированный бинарный файл никогда не завершится сбоем (например, из-за ошибок безопасности памяти) при любом входном файле размером менее 64 МБ.
Ключевые факты эксперимента:
- Claude успешно создал доказательства для 239 точек входа в 123 различных библиотеках OSS-Fuzz.
- Доказательства оперируют на уровне скомпилированных инструкций RISC-V.
- Общий объем написанных доказательств составил около 180 миллионов строк на языке Rocq.
- Типичное доказательство занимает около 600 000 строк для бинарного файла с медианной длиной 18 000 инструкций RISC-V.
- Доказательства работают при строгих допущениях: программа выполняется как однопоточный статический бинарный файл с фиксированным бюджетом памяти на процессоре RISC-V под управлением ОС Linux.
В ходе работы Claude также обнаружил и исправил ошибки, которые не были выявлены ранее, несмотря на триллионы запусков фаззинг-тестов.
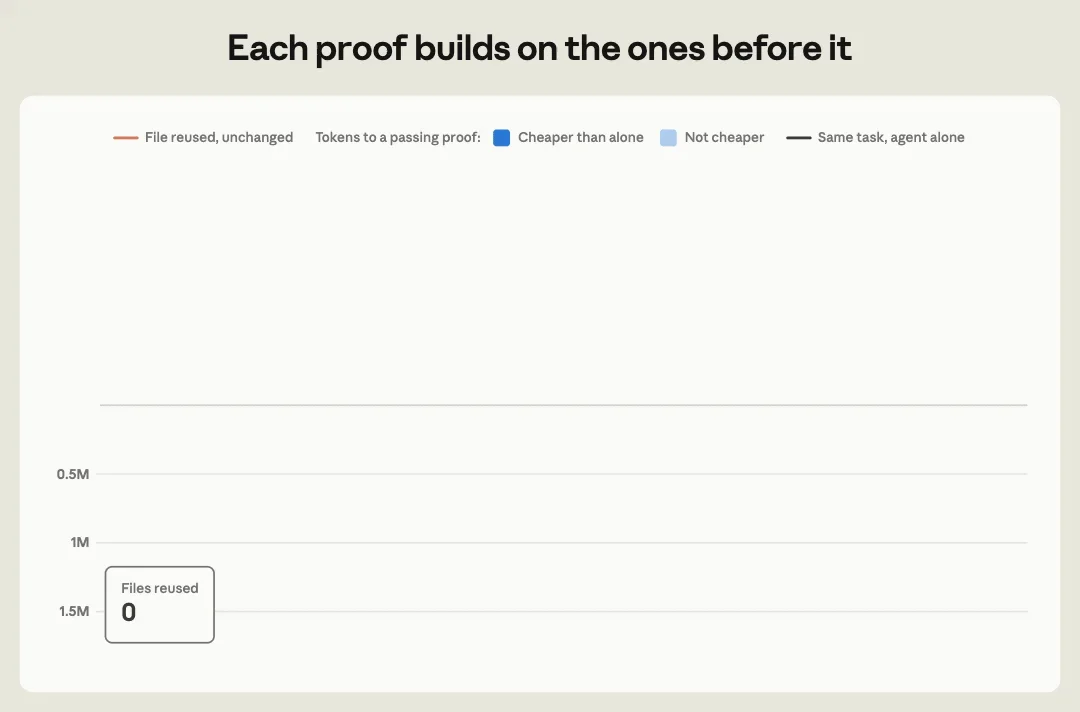
Chart of 36 proofs in finishing order, with arcs joining proofs that share a file and bars showing the tokens spent on each proof compared with an agent working alone.
Анализ
Этот эксперимент показывает фундаментальный сдвиг в разработке безопасного программного обеспечения. Использование LLM позволяет преодолеть главный барьер формальной верификации — астрономическую стоимость написания ручных доказательств. Автоматический перевод существующих тестов в строгие математические спецификации позволяет применять математические гарантии безопасности к обычным проектам с открытым исходным кодом, а не только к узкоспециализированному аэрокосмическому ПО.
Тот факт, что ИИ способен генерировать миллионы строк сложного кода для систем автоматического доказательства теорем (таких как Rocq), говорит о растущей способности моделей к длительному и логически строгому выводу.
Перспектива
По мере развития интеллектуальных способностей моделей стоимость написания доказательств будет продолжать снижаться. Текущие ограничения (только RISC-V, только Linux, однопоточность) могут быть преодолены путем стандартизации семантики для других процессорных архитектур и процессов операционных систем. Со временем, когда больше кода будет формализовано, возможность повторного использования доказательств сделает формальную верификацию стандартным и неотъемлемым этапом безопасной разработки программного обеспечения.
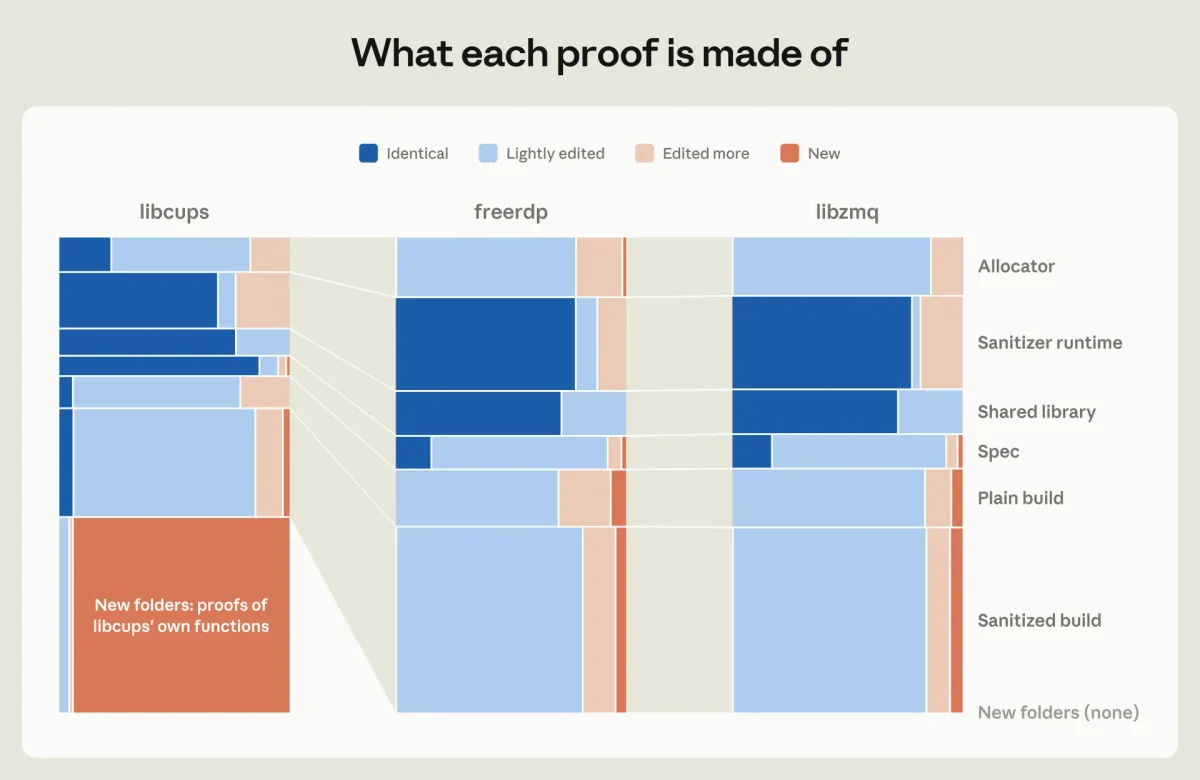
Block chart of the proofs for libcups, freerdp, and libzmq, showing how much of each part was identical, lightly edited, edited more or new.
LLMs are making formal software verification feasible at a much larger scale
TL;DR
Главное
Большие языковые модели делают формальную верификацию кода масштабируемой, позволяя математически доказывать безопасность обычного программного обеспечения с открытым исходным кодом.
Ключевые факты
- /Claude верифицировал 123 open-source библиотеки на уровне ассемблера RISC-V.
- /Сгенерировано около 180 млн строк кода доказательств на языке Rocq.
- /Доказано отсутствие сбоев для входных данных размером до 64 МБ при определенных условиях ОС и архитектуры.
- /Claude нашел ошибки, пропущенные при триллионах запусков традиционных тестов.
Инсайт
Перепрофилирование существующих фаззинг-тестов в строгие спецификации для ИИ решает проблему описания «правильного поведения» программы, делая верификацию применимой к уже существующим базам кода без переписывания архитектуры.