Единая система памяти для ИИ-агентов: Как устроена архитектура PlugMem от Microsoft
Исследователи из Microsoft предложили новый подход к памяти автономных систем. Технология PlugMem преобразует сырые логи взаимодействий в структурированные знания, экономя токены.
Современные агенты искусственного интеллекта сталкиваются с фундаментальной проблемой: они быстро забывают прошлый опыт или, наоборот, тонут в огромных массивах неструктурированных данных. Исследовательское подразделение Microsoft представило PlugMem — универсальную систему памяти, которая призвана решить эту задачу, превращая сырую историю взаимодействий в переиспользуемые структурированные знания.
До появления подобных систем большинство агентов полагались на простое добавление прошлых диалогов и действий в контекстное окно больших языковых моделей (LLM). Этот подход имеет два критических недостатка. Во-первых, он стремительно расходует доступные токены, что делает работу агента дорогой и медленной. Во-вторых, чем больше «сырого» текста находится в контексте, тем сложнее модели выделить действительно важную информацию для принятия текущего решения.
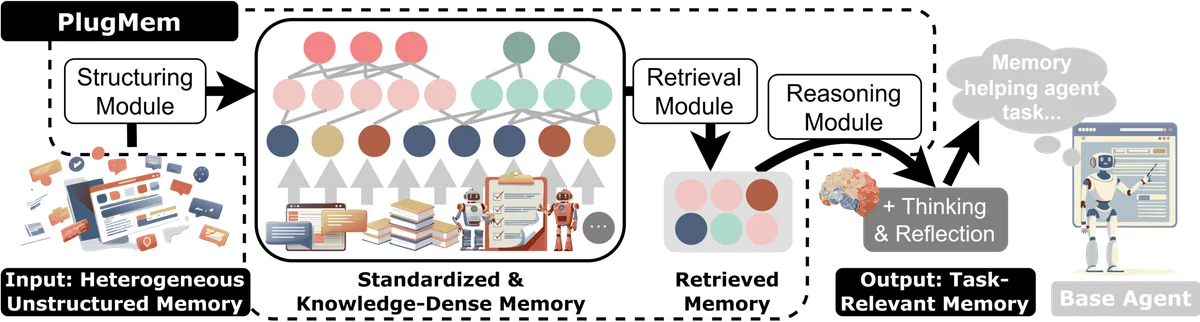
Figure 1. PlugMem organizes different types of agent interactions into a knowledge-centric memory graph, enabling structured retrieval and reasoning.
Архитектура PlugMem предлагает иной путь. Вместо того чтобы хранить каждый шаг агента как непрерывный текст, система анализирует историю и извлекает из нее полезные факты, правила и закономерности. Эта информация структурируется и сохраняется в виде базы знаний. Когда агенту нужно принять новое решение, PlugMem предоставляет только релевантные данные, игнорируя информационный шум. Система спроектирована как универсальный модуль: ее можно интегрировать с любым агентом без необходимости переписывать его базовую логику.
С технической точки зрения это означает значительное снижение нагрузки на вычислительные мощности. Использование структурированной памяти позволяет резко сократить потребление токенов, так как в модель передается выжимка опыта, а не полная стенограмма прошлых сессий. При этом качество принимаемых решений возрастает, поскольку агент получает четкие инструкции, основанные на его же успешных или ошибочных действиях в прошлом.
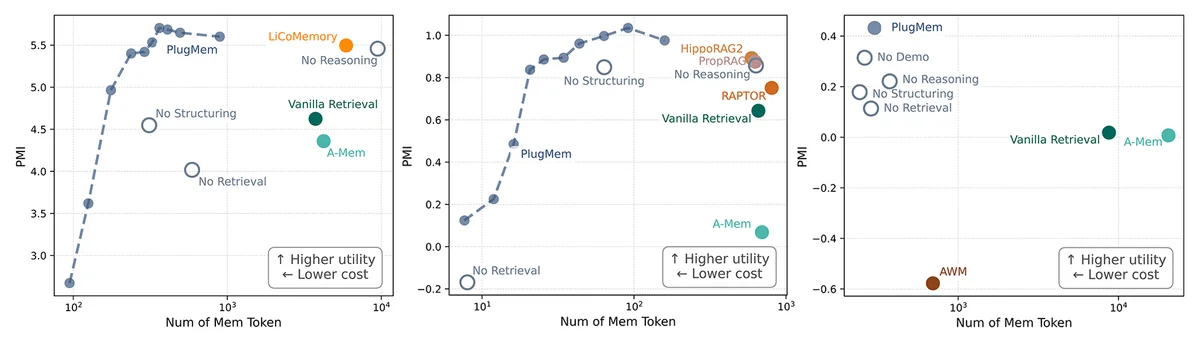
Figure 2. Across all three benchmarks, PlugMem delivered more useful memory with less of the agent’s context window.
Для индустрии это важный шаг в сторону создания по-настоящему автономных систем. Переход от «сырой» памяти к семантической структурированной базе знаний делает агентов более предсказуемыми и масштабируемыми. Разработчикам больше не нужно искать компромисс между размером контекстного окна и способностью агента помнить свой опыт.
В перспективе подобные модульные системы памяти могут стать таким же стандартом для ИИ-агентов, каким сегодня являются реляционные базы данных для традиционных веб-приложений. Время покажет, насколько быстро сообщество адаптирует этот подход, но направление развития очевидно: агенты должны не просто собирать данные, но и уметь их осмысливать.
Three white line icons on a blue-to-purple gradient background: the first icon shows a simple flowchart with connected squares and a diamond, the second icon depicts a network of interconnected circles, and the third icon represents a social connection diagram with three user profile symbols linked together.
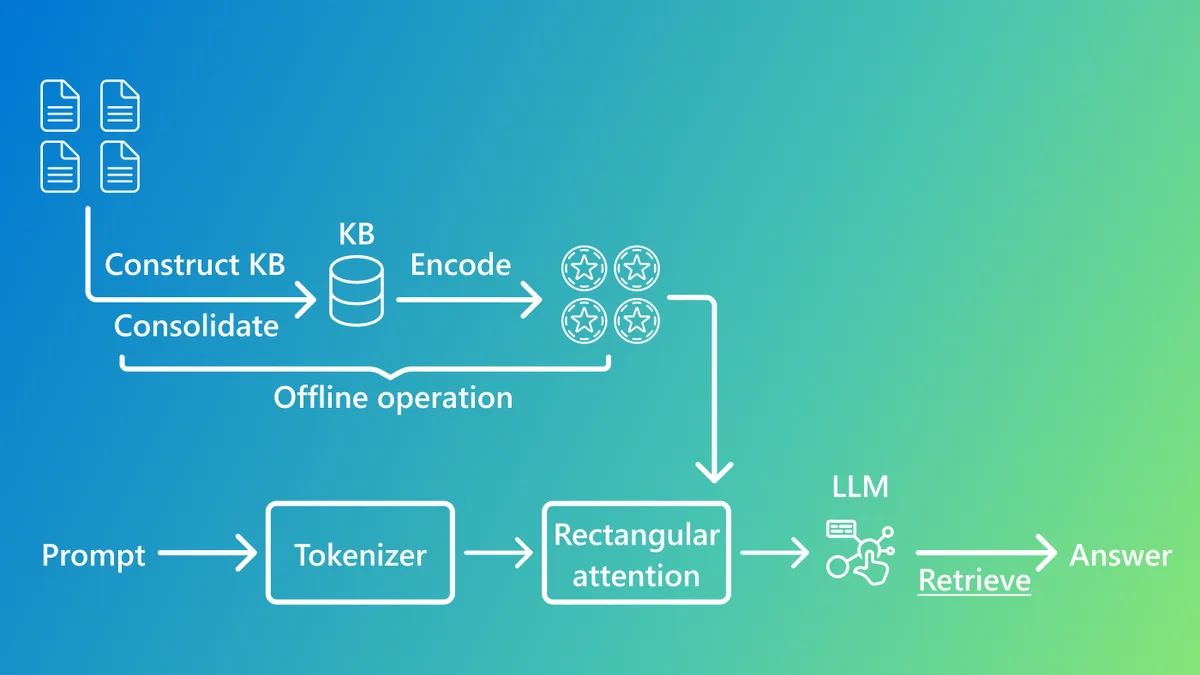
KBLaM blog | A flowchart illustrating the process of handling a prompt using a language model. The process begins with documents being used to construct and summarize a knowledge base (KB) offline. The summarized KB is then encoded and fed into the main process. A prompt goes through a tokenizer, followed by rectangular attention, and then into the large language model (LLM). The LLM retrieves information from the encoded KB to generate an answer.
blue and purple gradient background with decorative white icons
Изображение из источника
decorative icons in white on a blue and green gradient background
white line icons on blue and green gradient background
TL;DR
Главное
Microsoft разработала PlugMem — систему, которая заменяет хранение сырых логов ИИ-агентов на структурированную базу знаний, снижая затраты на вычисления и повышая качество решений.
Ключевые факты
- /PlugMem интегрируется с любыми ИИ-агентами как универсальный модуль.
- /Система преобразует историю действий в переиспользуемые знания.
- /Подход значительно снижает расход токенов контекстного окна LLM.
Инсайт
Главная ценность PlugMem заключается не в увеличении объема памяти агента, а в способности системы фильтровать информационный шум, предоставляя модели только критически важные факты для конкретной задачи.