NVIDIA представила метод генерации синтетических данных Code Concepts для обучения ИИ программированию
Исследователи NVIDIA создали набор из 15 миллионов задач на Python, чтобы точечно улучшать навыки написания кода у больших языковых моделей, и выложили его в открытый доступ.
Суть
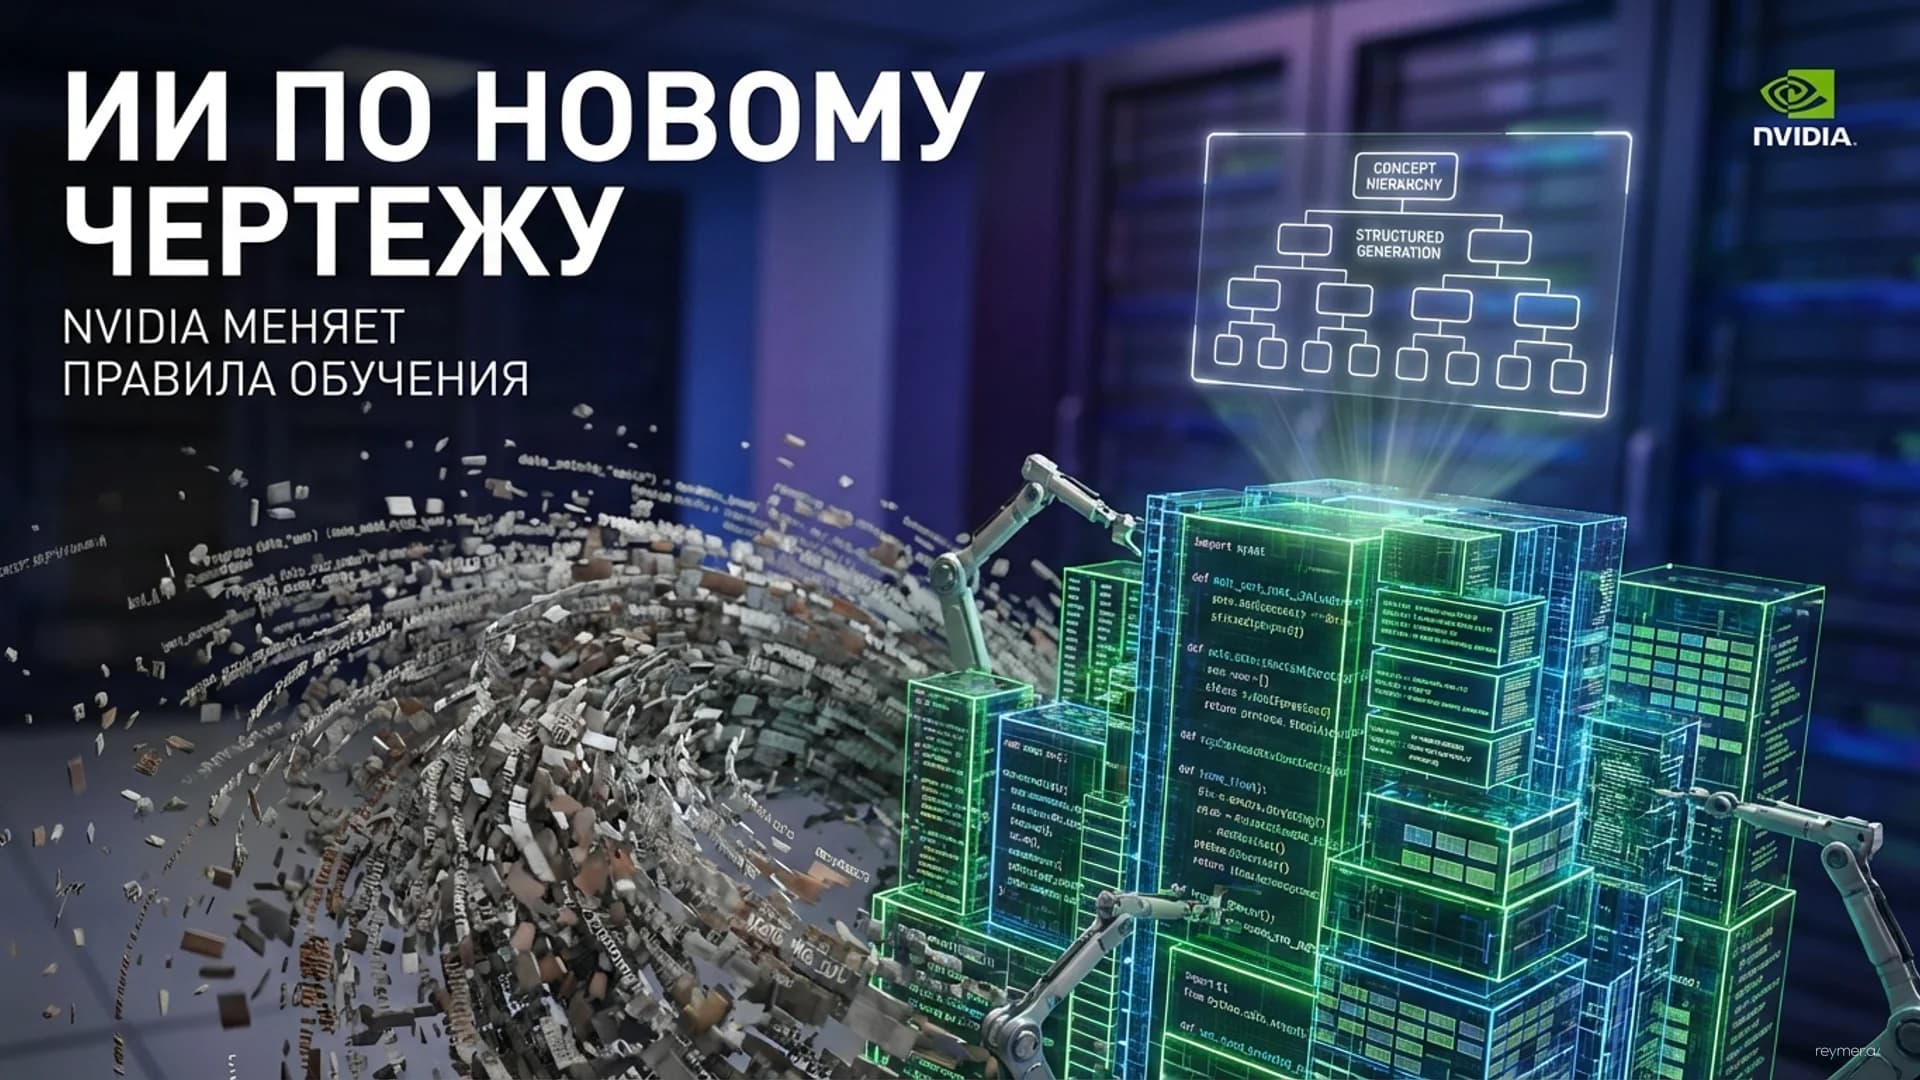
Компания NVIDIA опубликовала новый подход к созданию синтетических данных для обучения больших языковых моделей (LLM). Исследователи разработали метод генерации обучающих примеров, который опирается на строгую иерархию концепций программирования. В качестве доказательства работоспособности подхода они выпустили датасет Code Concepts, содержащий около 15 миллионов уникальных задач на языке Python. Эксперименты показали, что добавление этих данных на финальных этапах обучения модели существенно повышает ее способность писать и анализировать код.
Контекст
Исторически качество языковых моделей улучшалось за счет увеличения объема тренировочных данных, собранных из открытых источников в интернете. Однако у этого подхода есть предел. Стандартные массивы текстов содержат огромный объем информации, но им часто не хватает концептуальной точности, необходимой для развития специфических навыков.
Когда речь заходит о программировании или сложной логике, модели нужно не просто «видеть» много кода, а понимать базовые структуры: от простых строк и рекурсии до сложных алгоритмов на графах. Чтобы решить эту проблему, индустрия все чаще обращается к синтетическим данным — информации, сгенерированной другими, более мощными нейросетями по заданным правилам.
Детали
В основе подхода NVIDIA лежит специально созданная таксономия знаний о программировании. Она классифицирует тысячи концепций, выстраивая их от фундаментальных конструкций до продвинутых паттернов проектирования.
Процесс создания датасета Code Concepts выглядел следующим образом:
- Исследователи выделили 91 ключевую концепцию, наиболее релевантную для популярного теста оценки навыков программирования HumanEval.
- Комбинируя эти концепции (например, объединяя операции с множествами и вычислительную геометрию), они сформировали инструкции для генерации кода.
- С помощью мощной модели (в данном случае GPT-OSS 120B) было сгенерировано около 15 миллионов задач на Python.
- Каждый сгенерированный фрагмент прошел автоматическую проверку на синтаксическую корректность с использованием встроенной в Python функции
ast.parse.
Чтобы проверить эффективность, NVIDIA добавила 10 миллиардов токенов из нового датасета в последние 100 миллиардов токенов при предобучении своей модели Nemotron-Nano-v3. Результат — рост точности на бенчмарке HumanEval на шесть пунктов (с 73 до 79), при этом показатели на остальных, не связанных с кодом тестах, не ухудшились.
Анализ
Этот релиз демонстрирует важный сдвиг в индустрии искусственного интеллекта: переход от экстенсивного сбора данных к их интенсивному конструированию. Вместо того чтобы надеяться, что модель сама выучит редкий алгоритм из случайной статьи на GitHub, разработчики могут целенаправленно «внедрить» это знание, сгенерировав тысячи разнообразных примеров на нужную тему.
Использование строгой таксономии позволяет контролировать сложность, разнообразие и баланс тем в датасете. Это делает процесс обучения предсказуемым. Качественный анализ показал, что модель стала лучше справляться с пограничными случаями (edge cases) и сложными структурами данных.
Перспектива
Сама по себе публикация набора из 15 миллионов задач — большое событие для разработчиков открытых моделей. Однако авторы подчеркивают, что рассматривают этот релиз не как разовый артефакт, а как валидацию всего рабочего процесса (workflow).
NVIDIA опубликовала и сам датасет, и лежащую в его основе таксономию под пермиссивной лицензией CC-BY-4.0. Ожидается, что открытое сообщество начнет применять этот метод не только для программирования, но и для других предметных областей — от математики и юриспруденции до медицины, где также требуется глубокое понимание сложной иерархии концепций.
TL;DR
Главное
NVIDIA доказала, что целенаправленная генерация синтетических данных на основе иерархии концепций значительно эффективнее неструктурированного сбора информации для обучения ИИ сложным навыкам.
Ключевые факты
- /Сгенерировано 15 млн задач на Python на базе 91 концепции программирования.
- /Для фильтрации нерабочего кода использовалась строгая проверка синтаксиса (ast.parse).
- /Добавление 10 млрд токенов датасета в обучение Nemotron-Nano-v3 дало прирост в 6 пунктов на бенчмарке HumanEval.
- /Датасет и таксономия открыты для сообщества по лицензии CC-BY-4.0.
Инсайт
Главная ценность релиза заключается не в самом наборе данных для Python, а в подтвержденной методологии управляемой генерации, которую теперь можно масштабировать на любые другие научные и профессиональные дисциплины.