NVIDIA представила мультимодальную модель Nemotron 3 Nano Omni для создания эффективных ИИ-агентов
Открытая модель объединяет обработку текста, зрения и звука в единой архитектуре, повышая пропускную способность агентных систем до 9 раз по сравнению с аналогами.
Компания NVIDIA анонсировала выпуск Nemotron 3 Nano Omni — открытой мультимодальной модели, предназначенной для работы с видео, аудио, изображениями и текстом в рамках единой системы. Этот релиз знаменует важный шаг в развитии агентного искусственного интеллекта (agentic AI), предлагая разработчикам инструмент для создания более быстрых и автономных систем.
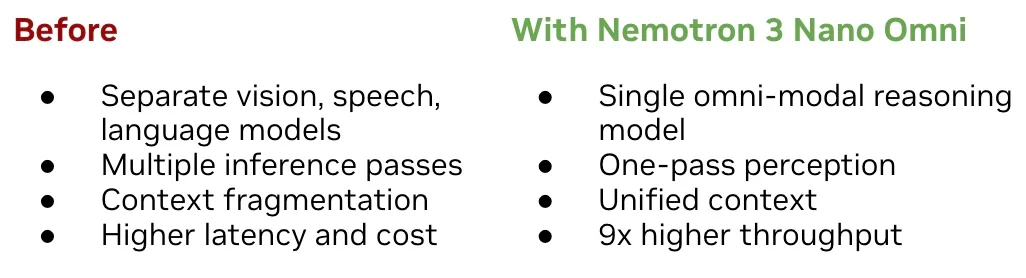
До сих пор большинство ИИ-агентов строились на базе разрозненных архитектур. Например, для обработки звонка клиента в службу поддержки системе требовалось использовать одну модель для распознавания речи (speech-to-text), другую — для анализа текста (большие языковые модели, LLM), и третью — для анализа происходящего на экране.
Такой подход неизбежно ведет к увеличению задержек из-за многократных циклов вывода (inference). Кроме того, при передаче данных от одной нейросети к другой теряется часть контекста, возрастают вычислительные затраты и накапливаются ошибки.
Nemotron 3 Nano Omni решает эту проблему путем интеграции визуальных и звуковых энкодеров непосредственно в свою гибридную архитектуру, построенную по принципу «смеси экспертов» (mixture-of-experts, MoE) формата 30B-A3B. Это устраняет необходимость в отдельных моделях восприятия.
Изображение из источника
Согласно данным NVIDIA, новая архитектура позволяет достичь пропускной способности, которая до 9 раз превышает показатели других открытых мультимодальных моделей с аналогичным уровнем интерактивности. Это означает снижение затрат на инфраструктуру и улучшение масштабируемости без ущерба для качества ответов.
Особое внимание в релизе уделено практическим сценариям применения модели в агентных рабочих процессах. NVIDIA выделяет три ключевых направления.
Во-первых, это агенты для использования компьютера (computer use agents). Модель способна обрабатывать визуальную информацию в нативном разрешении 1920x1080 пикселей. Это критически важно для навигации по сложным графическим интерфейсам. Компания H Company уже использует Nemotron 3 Nano Omni для интерпретации записей экрана в формате Full HD в реальном времени, что ранее было технически затруднительно из-за высоких задержек.
Во-вторых, интеллектуальная обработка документов (document intelligence). Модель может анализировать не только сплошной текст, но и структуру: графики, таблицы, скриншоты и смешанные медиа-форматы. Это открывает новые возможности для корпоративной аналитики и систем комплаенса, где важен контекст визуального расположения данных.
Изображение из источника
В-третьих, комплексное понимание аудио и видео. В системах мониторинга или обслуживания клиентов модель поддерживает единый поток рассуждений, связывая воедино то, что было сказано, показано на экране и задокументировано в логах, вместо создания разрозненных текстовых сводок.
Стратегическое значение этого релиза заключается в его открытости. NVIDIA предоставляет не только веса модели, но и наборы данных, а также методы обучения. Разработчики могут использовать инструменты вроде NVIDIA NeMo для тонкой настройки (fine-tuning) под специфические отраслевые задачи.
Открытая лицензия и легкая архитектура позволяют разворачивать Nemotron 3 Nano Omni как в облачных средах, так и на локальных серверах (on-premise), включая рабочие станции NVIDIA DGX. Это особенно важно для корпоративного сектора, где существуют строгие нормативные требования к локализации данных и цифровому суверенитету.
В будущем мы, вероятно, увидим интеграцию подобных мультимодальных систем в качестве базового слоя восприятия для более сложных ИИ-агентов. Nemotron 3 Nano Omni может работать в связке с более крупными моделями (например, Nemotron 3 Ultra), где Nano отвечает за быстрый сбор и первичную обработку сенсорных данных, а Ultra — за долгосрочное планирование и принятие сложных решений. Время покажет, насколько быстро индустрия сможет адаптировать эти инструменты для создания полностью автономных цифровых помощников.
From Rainforests to Recycling Plants: 5 Ways NVIDIA AI Is Protecting the Planet
Autonomous AI at Scale: Adobe Agents Unlock Breakthrough Creative Intelligence With NVIDIA and WPP
TL;DR
Главное
Объединение обработки текста, звука и видео в одной открытой модели устраняет задержки при передаче контекста, открывая путь к созданию быстрых ИИ-агентов, способных работать в реальном времени.
Ключевые факты
- /Архитектура 30B-A3B базируется на принципе смеси экспертов (MoE).
- /Пропускная способность модели до 9 раз выше, чем у открытых аналогов.
- /Поддерживается нативное разрешение 1920x1080 для точного анализа интерфейсов.
- /Модель выпущена с открытыми весами и обучающими наборами данных.
Инсайт
Главное преимущество новой модели заключается не в улучшении качества генерации текста, а в устранении архитектурного «бутылочного горлышка» — необходимости использовать разные нейросети для разных органов чувств ИИ.