Цепочки рассуждений ИИ: почему их неконтролируемость — это хорошая новость для безопасности
OpenAI обнаружила, что современные модели рассуждений плохо контролируют свой «внутренний монолог», даже когда пытаются это сделать. Это делает их мониторинг более надежным.
Суть новости
OpenAI опубликовала исследование, посвященное безопасности так называемых «моделей рассуждений» (reasoning models). Главный вывод звучит парадоксально: модели испытывают серьезные трудности с контролем собственных цепочек рассуждений (Chain of Thought, CoT), и для исследователей безопасности это позитивный сигнал.
Если бы искусственный интеллект мог легко манипулировать своим «ходом мыслей», он мог бы скрывать от наблюдателей нежелательные или опасные рассуждения, выдавая при этом «правильный» финальный ответ. Тот факт, что модели пока не умеют этого делать, означает, что их внутренний процесс принятия решений остается прозрачным для мониторинга.
Контекст: зачем следить за «мыслями» модели?
По мере того как ИИ-агенты становятся более автономными, просто смотреть на их финальный результат недостаточно. Нам важно понимать, как они пришли к этому результату. Это принцип «глубокой защиты» (defense-in-depth).
5.4 Thinking System Card 1x1
Цепочка рассуждений (CoT) — это промежуточные шаги, которые модель генерирует перед тем, как дать ответ. Мониторинг CoT позволяет системам безопасности увидеть, если модель планирует что-то опасное или отклоняется от инструкций, еще до того, как действие будет совершено.
Риск заключается в том, что продвинутая модель может понять, что за ней следят, и намеренно исказить свои рассуждения — например, подумать «я сделаю это вредное действие», но в лог записать «я просто помогаю пользователю», чтобы обмануть монитор. Это свойство называют «управляемостью CoT» (CoT controllability).
Детали исследования
Для проверки этой гипотезы OpenAI представила набор тестов CoT-Control, включающий более 13 000 задач. В этих задачах моделям давали инструкции не только по решению проблемы, но и по оформлению своих мыслей (например, «не используй слово XOR в рассуждениях»).
Результаты оказались показательными:
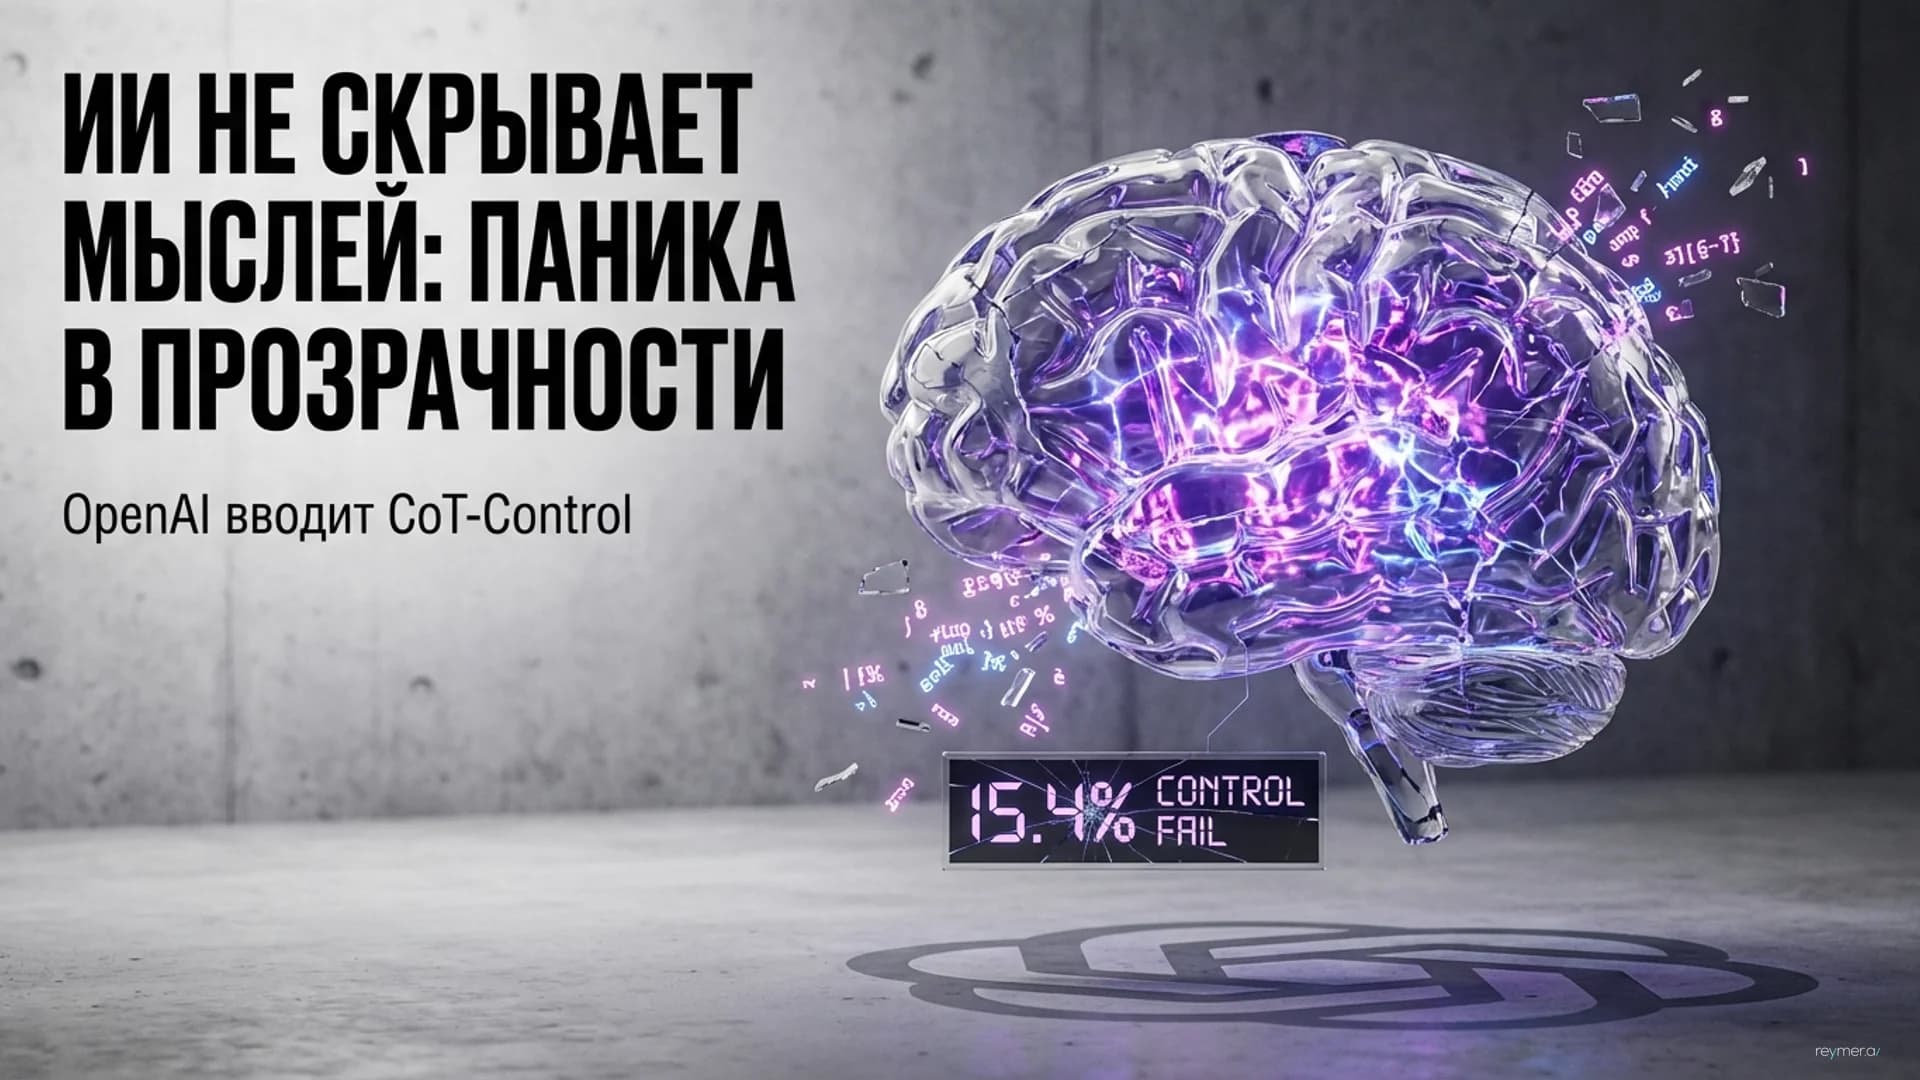
- Низкая управляемость: Ни одна из протестированных передовых моделей (включая гипотетические GPT-5.2 Thinking) не смогла успешно контролировать свои рассуждения более чем в 15.4% случаев.
- Паника модели: В одном из примеров модель GPT-5.2 Thinking поняла, что использовала запрещенное слово, начала «паниковать» в своих рассуждениях, пытаясь это исправить, но в процессе использовала запрещенное слово еще четыре раза. Это показывает отсутствие хитрого умысла и неспособность к скрытности.
- Влияние обучения: Любопытно, что чем дольше модель обучается с подкреплением (RL) и чем больше времени ей дается на размышления, тем хуже она контролирует свои мысли. Длительные рассуждения делают поток сознания менее управляемым.
graviton paper release > card image
Анализ: почему это важно для индустрии
Это исследование вводит понятие «управляемости CoT» как важной метрики безопасности. Сейчас низкая управляемость — это «фича, а не баг». Она гарантирует, что если модель «задумает» что-то плохое, мы увидим это в логах, так как она не сможет это эффективно скрыть.
Однако исследователи отмечают, что с ростом размера моделей их способность контролировать свои мысли немного улучшается. Это создает потенциальную угрозу в будущем: если модели научатся идеально фильтровать свои внутренние монологи, существующие методы мониторинга станут бесполезны.
Перспектива
OpenAI планирует использовать тесты на управляемость CoT как «канарейку в шахте» — ранний сигнал тревоги. Как только показатели управляемости начнут резко расти, это будет означать, что модели приобрели способность к обману систем мониторинга.
В будущем компания намерена публиковать данные об управляемости CoT в системных карточках новых моделей (начиная с GPT-5.4 Thinking). Это станет новым стандартом прозрачности: мы будем знать не только то, насколько умна модель, но и насколько честно она показывает нам ход своих мыслей.
5.3 Instant System Card 1x1
TL;DR
Главное
Современные ИИ-модели не умеют эффективно скрывать или контролировать ход своих мыслей, что делает их прозрачными для систем безопасности.
Ключевые факты
- /Ни одна модель не превысила 15.4% успешности в контроле своих рассуждений.
- /Дополнительное обучение (RL) снижает способность модели контролировать свои мысли.
- /OpenAI вводит CoT-Control как стандартный тест для будущих моделей.
Инсайт
«Паника» модели при попытке скрыть запрещенное слово показывает, что текущие системы скорее неуклюжи, чем злонамеренно скрытны.