Создание синтетических сред для оценки корпоративного ИИ: подход разработчиков Copilot
Как оценить эффективность ИИ в масштабах предприятия, не нарушая конфиденциальность данных клиентов. Решение на базе генерации синтетических рабочих пространств.
Суть
Исследователи разработали платформу для генерации синтетических корпоративных данных (Industry Evaluation Data Generation Platform). Эта система позволяет тестировать ИИ-помощника Microsoft Copilot в сложных, реалистичных сценариях, полностью исключая использование конфиденциальных данных реальных клиентов.
Контекст
Оценка корпоративного ИИ требует тестовых данных, отражающих всю сложность реальных организаций: структуры подчинения, истории проектов, шаблоны коммуникации и специфические рабочие процессы. Однако реальные корпоративные данные содержат конфиденциальную информацию, которую ни при каких обстоятельствах нельзя использовать для тестирования.
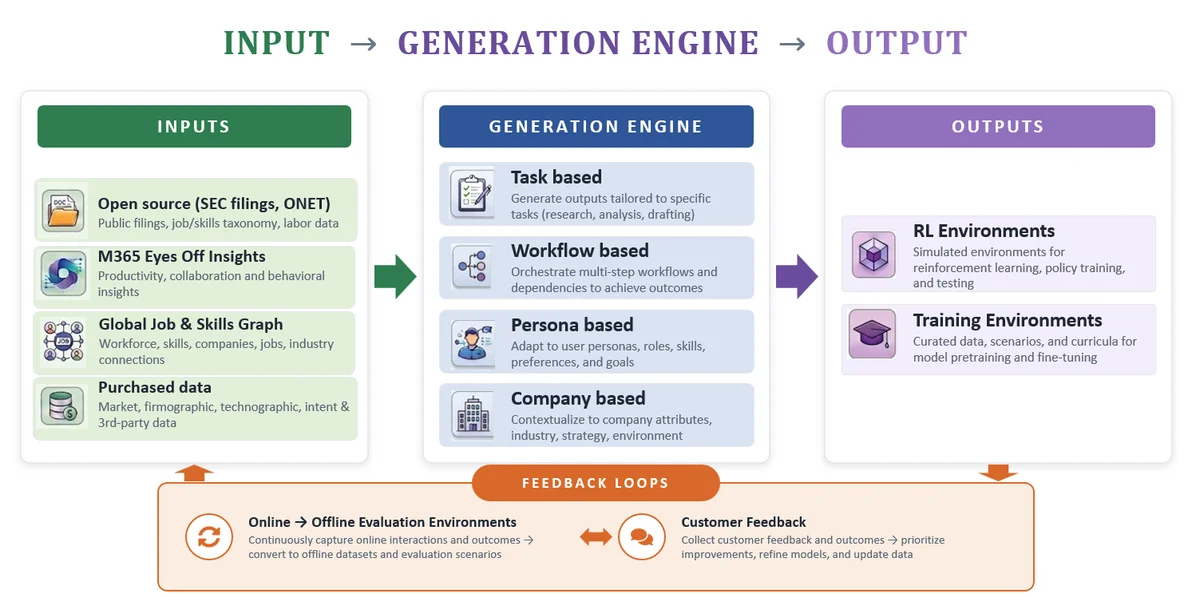
Figure 1: Components of Industry Evaluation Data Generation Platform
Чтобы разрешить это противоречие, вместо использования небольших, собранных вручную тестовых наборов, разработчики перешли к созданию полномасштабных синтетических сред. Эти симулированные рабочие пространства, называемые «тенантами», обладают собственными виртуальными пользователями, данными и конфигурациями.
Детали
Для обеспечения реалистичности синтетические среды опираются на публично доступные источники данных. База профессий Министерства труда США (O*NET) помогает калибровать роли и рабочие активности. Онлайн-вакансии дают реалистичные названия должностей и иерархии, а финансовая отчетность (SEC filings) информирует о масштабах организаций.
Платформа моделирует среды для трех конкретных отраслей:
- Фармацевтика (нормативные документы, клинические испытания).
- Рынки капитала (сделки, соблюдение нормативных требований).
- IT и программное обеспечение (планирование спринтов, обзоры кода).
Важным элементом является автоматизированный шестиэтапный конвейер генерации запросов. Он превращает базовые шаблоны в реалистичные, специфичные для отрасли вопросы к ИИ. По оценке компании, эта автоматизация сократила процесс создания набора данных для оценки с нескольких дней ручной работы до автоматизированных запусков. Это позволило сэкономить около 100 000 долларов на каждый набор данных и 300 000 долларов в рамках всего проекта.
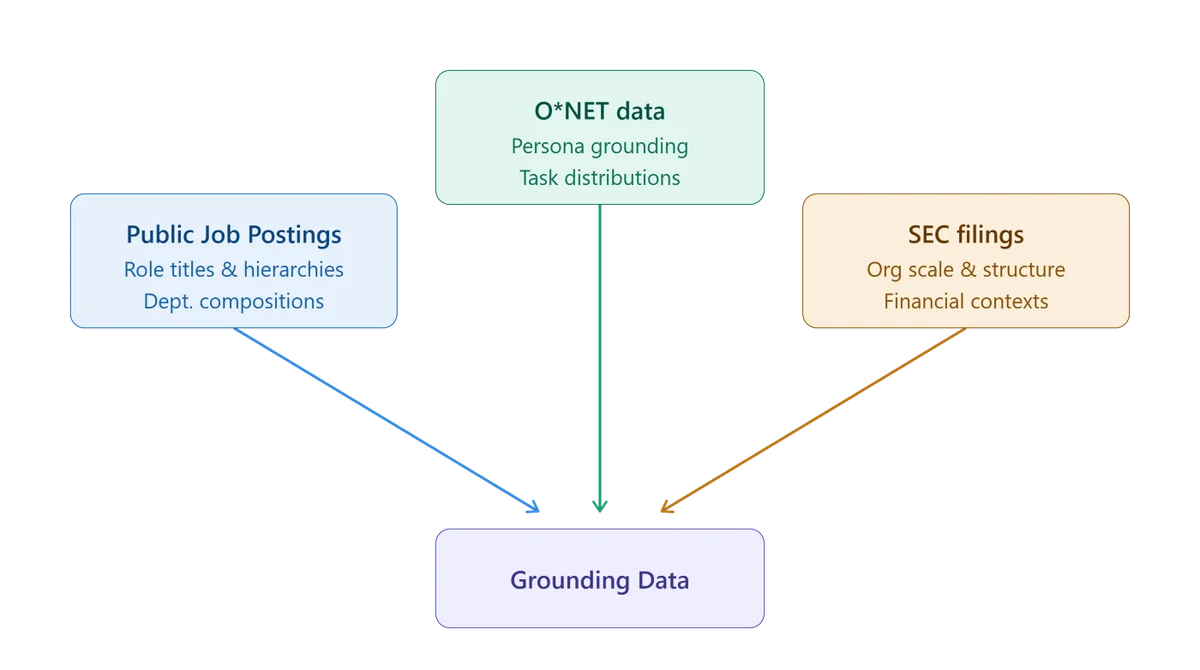
Figure 2: Real signals from public datasets that are used to ground the evaluation data generation
Качество синтетических данных оценивается по четырем параметрам: структурная точность, контекстуальная релевантность, поведенческий реализм и безопасность контента.
Анализ
Создание динамических синтетических сред решает фундаментальную проблему воспроизводимости и масштабируемости в тестировании ИИ. Ручные процессы неизбежно дают разные результаты при каждом запуске, что затрудняет сравнение версий продукта. Автоматизация позволяет любой команде регенерировать набор данных из той же конфигурации и получить идентичные результаты, что критически важно для стандартизации оценки.
Перспектива
Подход, при котором безопасность и конфиденциальность закладываются на уровне архитектуры (privacy by design), вероятно, станет стандартом для индустрии. Развитие подобных платформ позволит разработчикам корпоративного ИИ быстрее итерировать свои продукты, доказывая их эффективность и безопасность корпоративным заказчикам без компрометации реальных рабочих процессов.
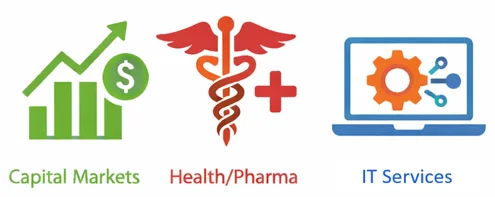
Figure 3: Industries targeted for industry evaluation data generation
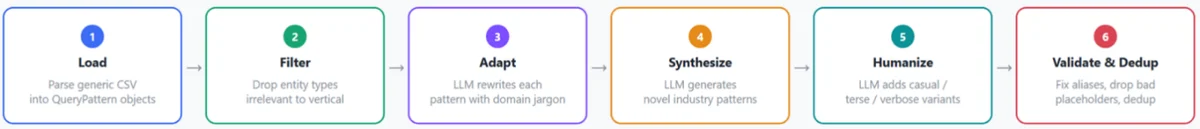
Figure 4: Query customization pipeline that turns generic query templates into realistic, industry-specific queries
Illustration on a purple and blue gradient background showing three white line icons: a hierarchical organizational chart, a checklist with checkmarks, and a shield. The icons visually represent structured data, evaluation criteria, and security or trustworthiness.
Research Forum | abstract background with colorful hexagons
TL;DR
Главное
Для оценки корпоративного ИИ создана платформа генерации полномасштабных синтетических сред, что позволяет тестировать модели без использования реальных данных клиентов.
Ключевые факты
- /Платформа моделирует рабочие среды для 3 отраслей: фармацевтика, рынки капитала, IT/ПО.
- /Для основы используются публичные данные: база O*NET, вакансии, отчеты SEC.
- /Автоматизация экономит около 100 000 долларов на создание одного набора данных.
- /Общая экономия проекта оценивается в 300 000 долларов.
Инсайт
Для качественной оценки ИИ недостаточно статических данных: симуляции должны развиваться во времени, так как многие запросы пользователей опираются на хронологию событий и историю переписки.