Google анонсировала запуск двух новых моделей: Gemini 3.8 Live и Gemini 3.8 Live Extended Thinking. Это голосовые интерфейсы нового поколения, которые делают взаимодействие с искусственным интеллектом более естественным, добавляя визуальный контекст и способность выполнять фоновые задачи без прерывания беседы. Обновление направлено на то, чтобы превратить ИИ из простого собеседника в полноценного партнера по решению рабочих задач.
Голосовые интерфейсы долгое время оставались линейными и ограниченными форматом «запрос — ожидание — ответ». Предыдущие поколения моделей часто теряли нить разговора при попытке выполнить внешнюю задачу, обратиться к базе данных или переключиться на другой язык. Паузы в ожидании ответа разрушали иллюзию естественного диалога. Теперь фокус индустрии сместился на непрерывность общения, мультимодальность и способность агента рассуждать в реальном времени.
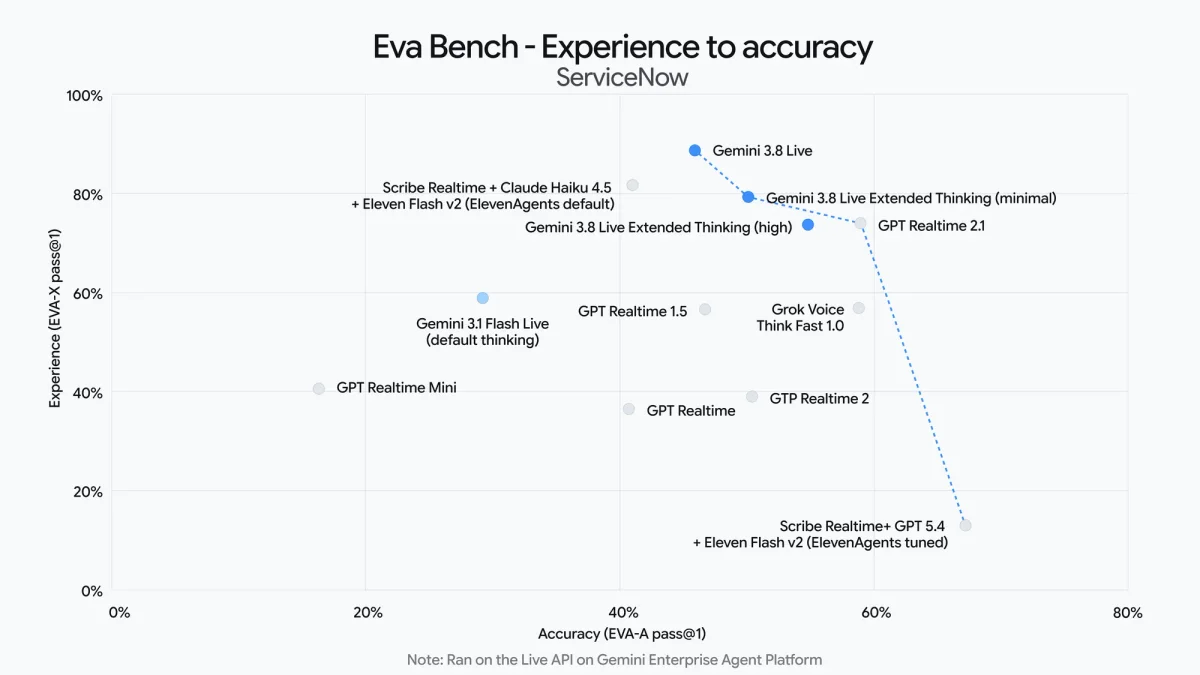
A chart showing EVA Bench Experience to Task Completion
Базовая модель Gemini 3.8 Live оптимизирована для масштабирования и экономической эффективности. Она способна обрабатывать визуальные данные почти в реальном времени, обогащая разговор контекстом из того, что «видит» камера. Модель автоматически распознает и переключается между 97 языками прямо в середине разговора.
Версия Extended Thinking предназначена для более сложных рабочих процессов. Она способна рассуждать и говорить одновременно. Модель заняла первое место в индексе качества речи (Speech to Speech Quality Index) от Artificial Analysis с результатом 82.6 балла и показала 97.7% на бенчмарке Big Bench Audio.
Text "Introducing Gemini 3.8 Live and 3.8 Live Extended Thinking" with the Gemini Spark, all on a light blue background
Ключевой технической особенностью обеих моделей стала возможность запускать вызовы инструментов (API) в фоновом режиме. Модель может использовать вербальные маркеры вроде «Дайте мне проверить это» и продолжать беседу с пользователем, пока задача выполняется на сервере. В целях безопасности все сгенерированные аудиоматериалы помечаются невидимым водяным знаком SynthID.
Это обновление демонстрирует важный сдвиг: переход от простых голосовых помощников к автономным агентам. Интеграция моделей в Google Workspace (Docs, Gmail, Keep) и Search означает, что пользователи смогут решать комплексные задачи с помощью естественного диалога. Например, координировать расписание или создавать бизнес-планы, просто обсуждая это с устройством. Архитектура фонового вызова инструментов решает главную проблему голосовых интерфейсов — долгое время ожидания при обращении к внешним системам.
С развитием подобных моделей грань между текстовым и голосовым взаимодействием будет стремительно стираться. Разработчики уже получили доступ к API через Google AI Studio, а также через платформы-партнеры вроде LangChain и Vercel, что неизбежно приведет к появлению множества сторонних приложений с продвинутым голосовым управлением. В ближайшем будущем такие системы с возможностью многошагового рассуждения могут стать стандартом для корпоративного сектора, технической поддержки и образования.